
本文翻译自: https://jalammar.github.io/illustrated-word2vec/
图解 Word2vec
万物皆有规律,这是我们宇宙的一部分。它具有对称性、优雅性和优美性 ——这些特质总能在真正的艺术家所捕捉的事物中找到。你可以在四季更迭中找到它,在沙丘沿着山脊的走向中找到它,在灌木丛的枝杈中找到它。 灌木丛或其叶子的图案。
我们试图在生活和社会中复制这些模式,寻求那些能带来慰藉的节奏、舞步和形式。然而,追求极致完美也可能暗藏危险。显然,极致的模式本身就包含着僵化。在这种完美中,万物最终都将走向死亡。《沙丘》(1965)
我认为词嵌入是机器学习中最引人入胜的概念之一。如果你用过 Siri、Google Assistant、Alexa、Google Translate,甚至是带有下一个单词预测功能的智能手机键盘,那么你很可能已经受益于这个已成为自然语言处理模型核心的概念。过去二十年来,词嵌入在神经网络模型中的应用取得了长足发展(最近的发展包括上下文词嵌入,由此催生了 BERT 和 GPT-2 等前沿模型)。
Word2vec 是一种高效创建词嵌入的方法,自 2013 年以来就已存在。除了作为词嵌入方法之外,它的一些概念也被证明在创建推荐引擎和理解序列数据方面非常有效,甚至在商业化的非语言任务中也能发挥作用。Airbnb、 阿里巴巴 、 Spotify 和 Anghami 等公司都受益于将这一源自自然语言处理 ( NLP) 领域的出色工具应用于生产环境中,从而打造出新一代的推荐引擎。
在这篇文章中,我们将探讨词嵌入的概念,以及如何使用 word2vec 生成词嵌入。但让我们先从一个例子开始,熟悉一下如何使用向量来表示事物。你知道吗?一个包含五个数字的列表(一个向量)就能代表你性格的很多方面。
人格嵌入:你是什么样的人?
“我向你介绍沙漠变色龙,它能将自己融入背景的能力,足以告诉你生态学的根源和个人身份的基石。”——《沙丘之子》
以 0 到 100 分来衡量,你的内向/外向程度如何(0 分最内向,100 分最外向)?你做过 MBTI 之类的性格测试吗?或者更好的选择是,做过“ 大五人格特质” 测试?如果你还没做过,这些测试会问你一系列问题,然后根据多个维度给你打分,内向/外向就是其中之一。
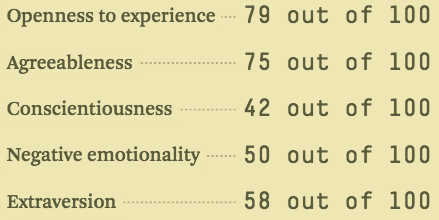
Example of the result of a Big Five Personality Trait test. It can really tell you a lot about yourself and is shown to have predictive ability in academic, personal, and professional success. This is one place to find your results.
这是“五大人格特质”测试结果的示例。它能让你更了解自己,并已被证明对 学业 、 个人生活 和 职业生涯的成功 具有预测能力。你可以在 这里 找到你的测试结果。
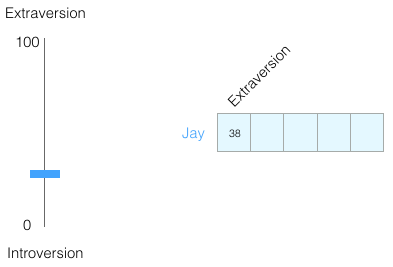
假设我的内向/外向得分是 38/100。我们可以这样绘制图表:
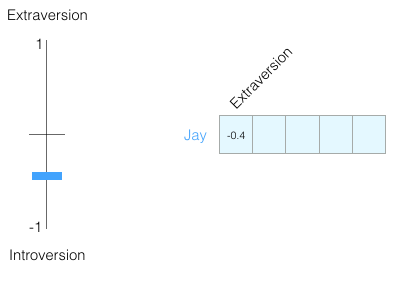
让我们把取值范围改为 -1 到 1:
仅凭这一条信息,你觉得自己对这个人了解多少?不多。人是很复杂的。所以,我们再增加一个维度——测试中另一项特质的得分。
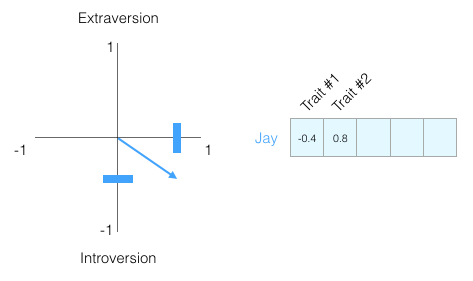
我们可以将二维空间表示为图上的一个点,或者更准确地说,表示为从原点到该点的向量。我们拥有强大的向量处理工具,这些工具很快就会派上用场。
我已经隐藏了我们正在绘制哪些特征,这样你就能习惯不知道每个维度代表什么——但仍然可以从一个人的性格的向量表示中获得很多价值。
现在我们可以说,这个向量部分地代表了我的性格。这种表示方法的用处在于,当你想把另外两个人与我进行比较时。假设我被 bus 撞了,需要找一个性格相似的人来代替我。在下图所示的两个人中,哪一个更像我?
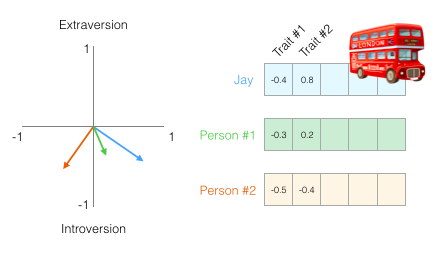
处理向量时,计算相似度得分的常用方法是 余弦相似度 :
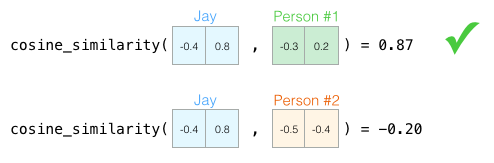
1 号人的性格与我更相似。指向同一方向的向量(长度也起作用)具有更高的余弦相似度得分。
然而,仅仅两个维度不足以捕捉到人与人之间差异的足够信息。数十年的心理学研究已经得出五大人格特质(以及许多子特质)。因此,让我们在比较中使用全部五个维度:
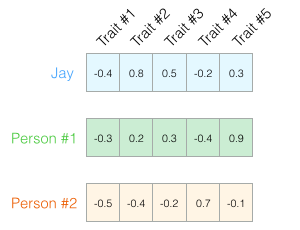
五维空间的问题在于,我们无法像二维空间那样绘制简洁的小箭头。这在机器学习中是一个常见的挑战,因为我们经常需要在高维空间中思考。不过,好消息是,余弦相似度仍然有效。它适用于任意维度:
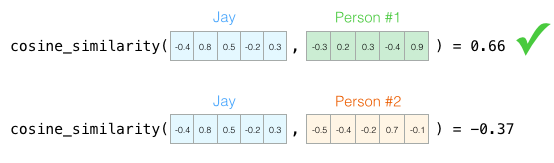
余弦相似度适用于任意维度。由于它是基于更高分辨率的被比较对象表示计算得出的,因此这些分数要好得多。
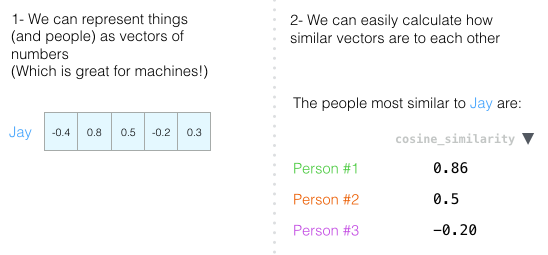
在本节结尾,我希望我们能得出两个中心思想:
- 我们可以将人(和事物)表示为数字向量(这对机器来说非常棒!)。
- 我们可以轻松计算出向量之间的相似度。
词嵌入
“语言的馈赠是欺骗和幻象的馈赠。”——《沙丘之子》
有了这种理解,我们就可以继续查看训练好的词向量示例(也称为词嵌入),并开始研究它们的一些有趣特性。
这是单词“king”的词嵌入(基于维基百科训练的 GloVe 向量):
` [ 0.50451 , 0.68607 , -0.59517 , -0.022801, 0.60046 , -0.13498 , -0.08813 , 0.47377 , -0.61798 , -0.31012 , -0.076666, 1.493 , -0.034189, -0.98173 , 0.68229 , 0.81722 , -0.51874 , -0.31503 , -0.55809 , 0.66421 , 0.1961 , -0.13495 , -0.11476 , -0.30344 , 0.41177 , -2.223 , -1.0756 , -1.0783 , -0.34354 , 0.33505 , 1.9927 , -0.04234 , -0.64319 , 0.71125 , 0.49159 , 0.16754 , 0.34344 , -0.25663 , -0.8523 , 0.1661 , 0.40102 , 1.1685 , -1.0137 , -0.21585 , -0.15155 , 0.78321 , -0.91241 , -1.6106 , -0.64426 , -0.51042 ] `
这是一个包含 50 个数字的列表。单看这些数字本身我们无法了解太多信息。但我们可以将其可视化,以便与其他词向量进行比较。让我们把所有这些数字放在一行中:

让我们根据单元格的值给它们涂上颜色(接近 2 用红色,接近 0 用白色,接近 -2 用蓝色):
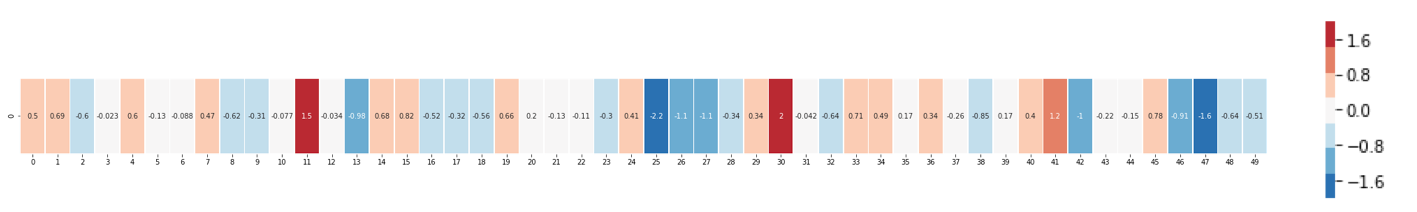
我们将忽略数字,只观察颜色来表示单元格的值。现在让我们把“King”与其他单词进行对比:
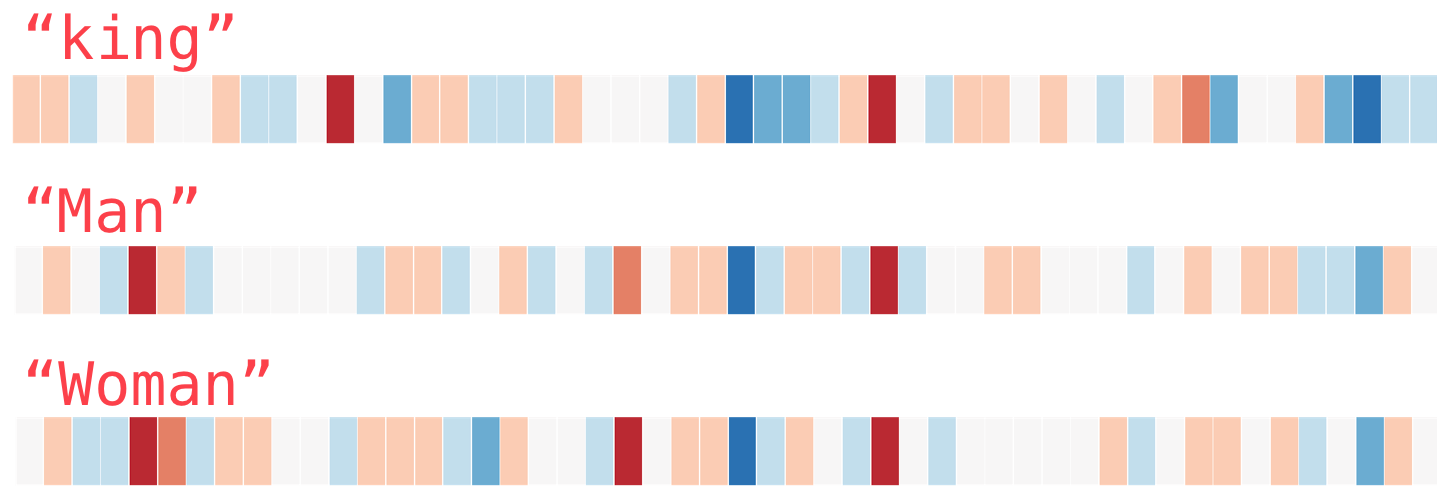
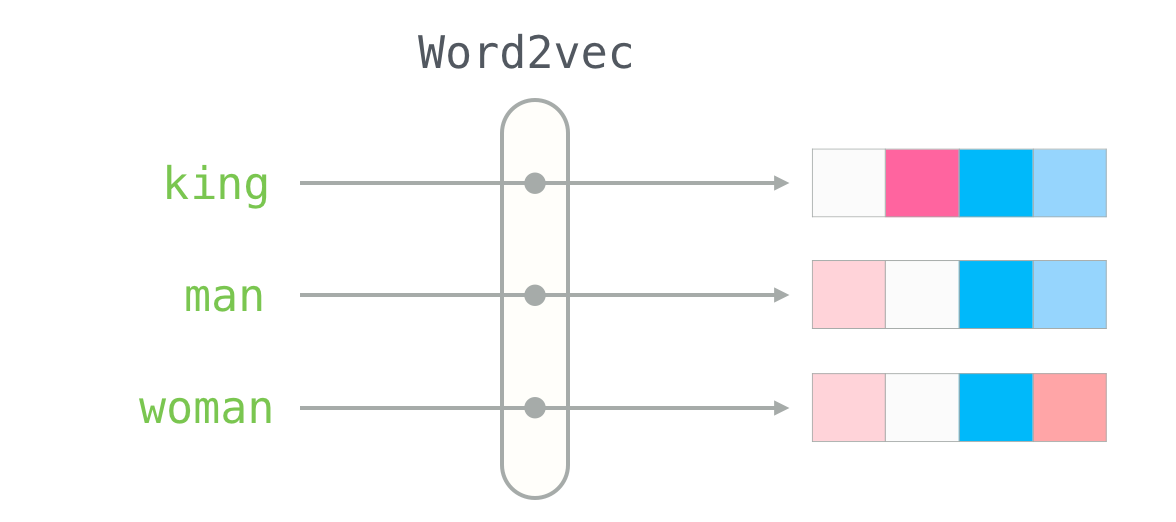
你看,“男人”和“女人”之间的相似度远高于它们各自与“国王”的相似度。这说明了一些问题。这些向量表示捕捉到了这些词语的大量信息、含义和联想。
以下是一些示例(请垂直扫描各列,查找颜色相似的列进行比较):
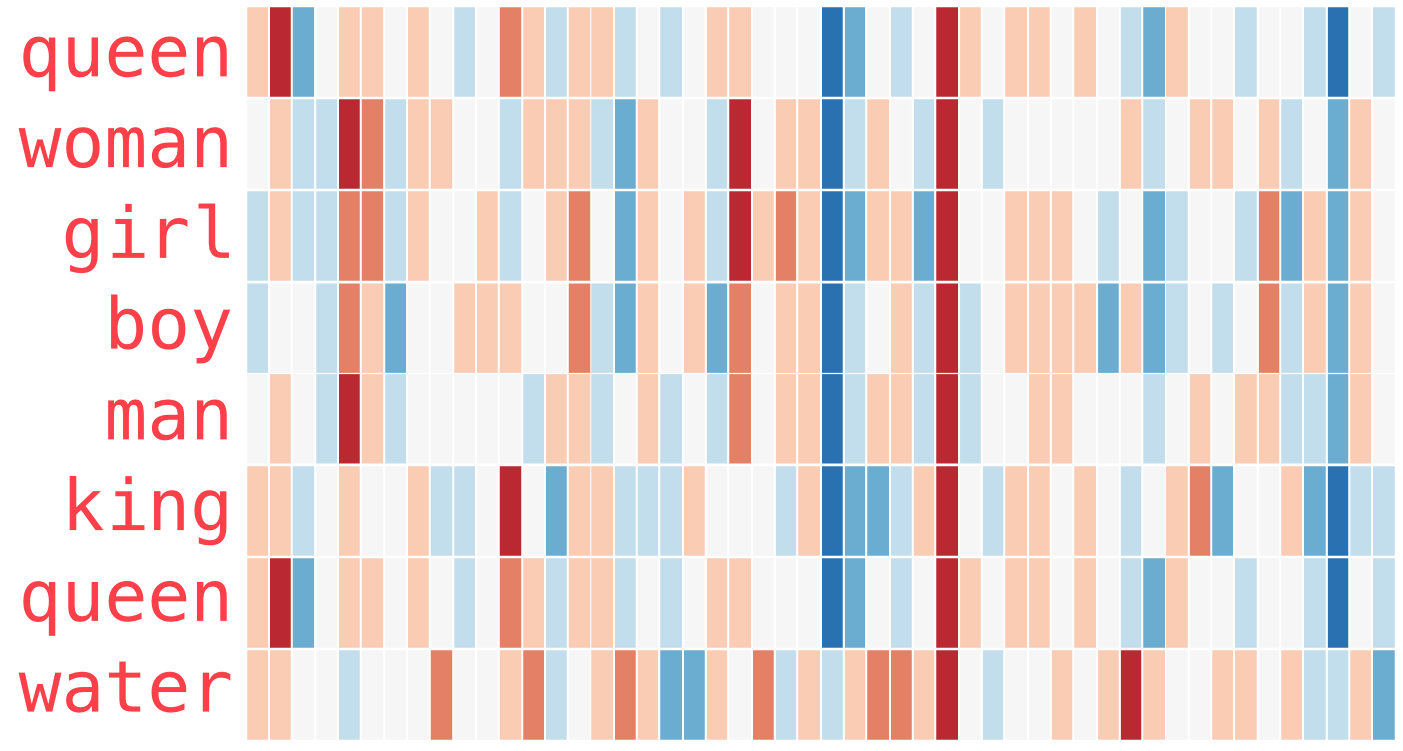
有几点需要指出:
- 所有这些不同的词语之间都有一条笔直的红色列。它们在这个维度上是相似的(但我们不知道每个维度代表什么)。
- 你可以看出,“女人”和“女孩”在很多地方都很相似。“男人”和“男孩”也是如此。
- “男孩”和“女孩”在某些方面彼此相似,但与“女人”或“男人”不同。这是否暗示了一种模糊的青春概念?有可能。
- 除了最后一个词之外,其余的词都代表人。我添加了一个物体(水)来展示不同类别之间的差异。例如,你可以看到那一列蓝色的词一直延伸到“水”这个词的嵌入位置之前。
- 有些地方,“国王”和“王后”的用法非常相似,但又与其他所有称谓截然不同。这是否暗示着某种模糊的皇室概念?
类比
“言语可以承载我们想要承载的任何重担。所需要的只是共识和可以赖以建立的传统。”——《沙丘之神帝》
词嵌入的一个惊人特性,最著名的例子就是类比的概念。我们可以对词嵌入进行加减运算,从而得到有趣的结果。最著名的例子是公式:“国王” - “男人” + “女人”:
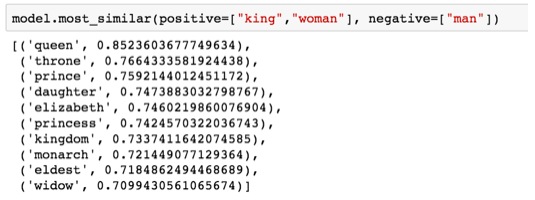
使用 Python 中的 Gensim 库,我们可以对词向量进行加减运算,它会找到与结果向量最相似的词。图中显示了最相似词的列表,每个词都标有其余弦相似度。
我们可以像之前那样,将这个类比形象化:
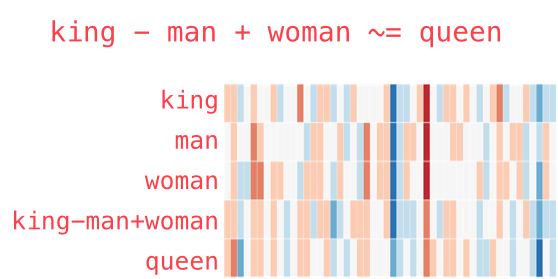
由“king-man+woman”得到的向量并不完全等于“queen”,但“queen”是我们在这个集合中拥有的 400,000 个词嵌入中最接近它的词。
既然我们已经了解了训练好的词嵌入,接下来让我们深入了解一下训练过程。但在学习 word2vec 之前,我们需要先了解一下词嵌入的概念基础:神经语言模型。
语言建模
先知不会被过去、现在和未来的幻象所迷惑。 语言的固定性决定了这种线性的区分。 先知掌握着开启语言之锁的钥匙。
这并非一个机械的宇宙。事件的线性进程是由观察者强加的。因果关系?根本不是那么回事。 先知吐露了预示命运的话语。 你瞥见了“注定要发生”之事。但预言的瞬间释放出无限的预兆和力量。宇宙经历了一场幽灵般的转变。《沙丘之神帝》
如果要举例说明自然语言处理(NLP)的应用,智能手机键盘的下一个单词预测功能就是最好的例子之一。数十亿人每天都会使用这项功能数百次。
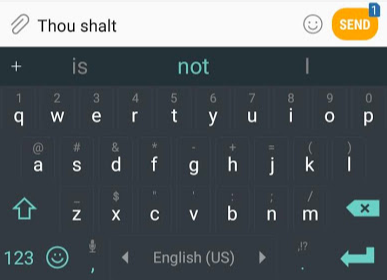
下一个词预测是 语言模型 可以解决的任务。语言模型可以接收一个单词列表(例如两个单词),并尝试预测它们后面的单词。
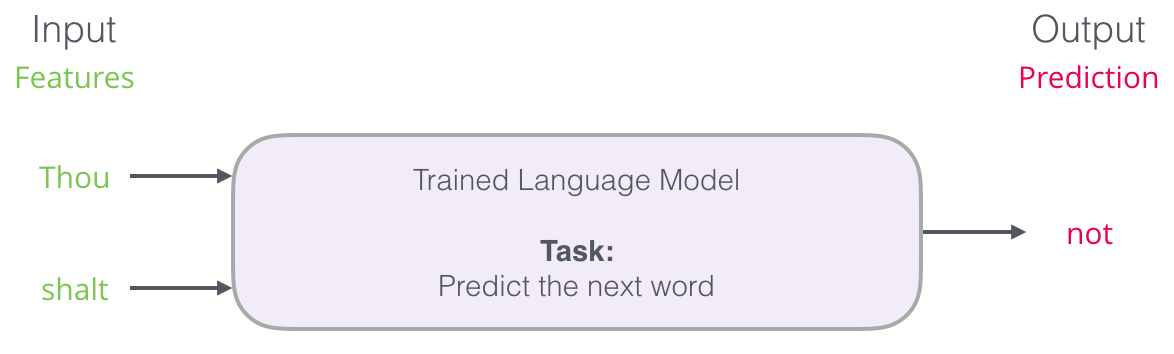
在上面的截图中,我们可以把这个模型看作是一个接收了这两个绿色单词( thou shalt )并返回一个建议列表的模型(其中“not”的概率最高):
我们可以把这个模型想象成这样一个黑盒子:
但实际上,该模型并非只输出一个单词。它实际上会输出所有已知单词的概率得分(即模型的“词汇表”,其大小从几千个单词到超过一百万个单词不等)。键盘应用程序随后需要找到得分最高的单词,并将它们呈现给用户。
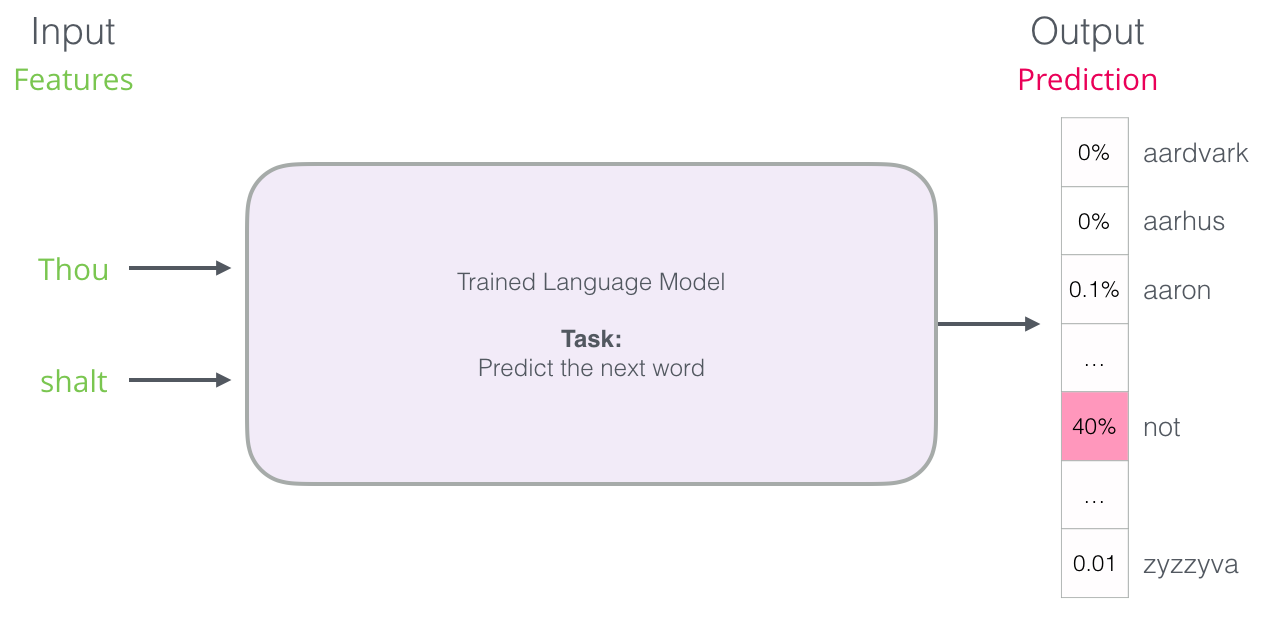
神经语言模型的输出是模型已知所有单词的概率得分。这里我们用百分比来表示概率,但实际上 40% 在输出向量中会表示为 0.4。
经过训练后,早期的神经语言模型( Bengio 2003 )会分三步计算预测结果:
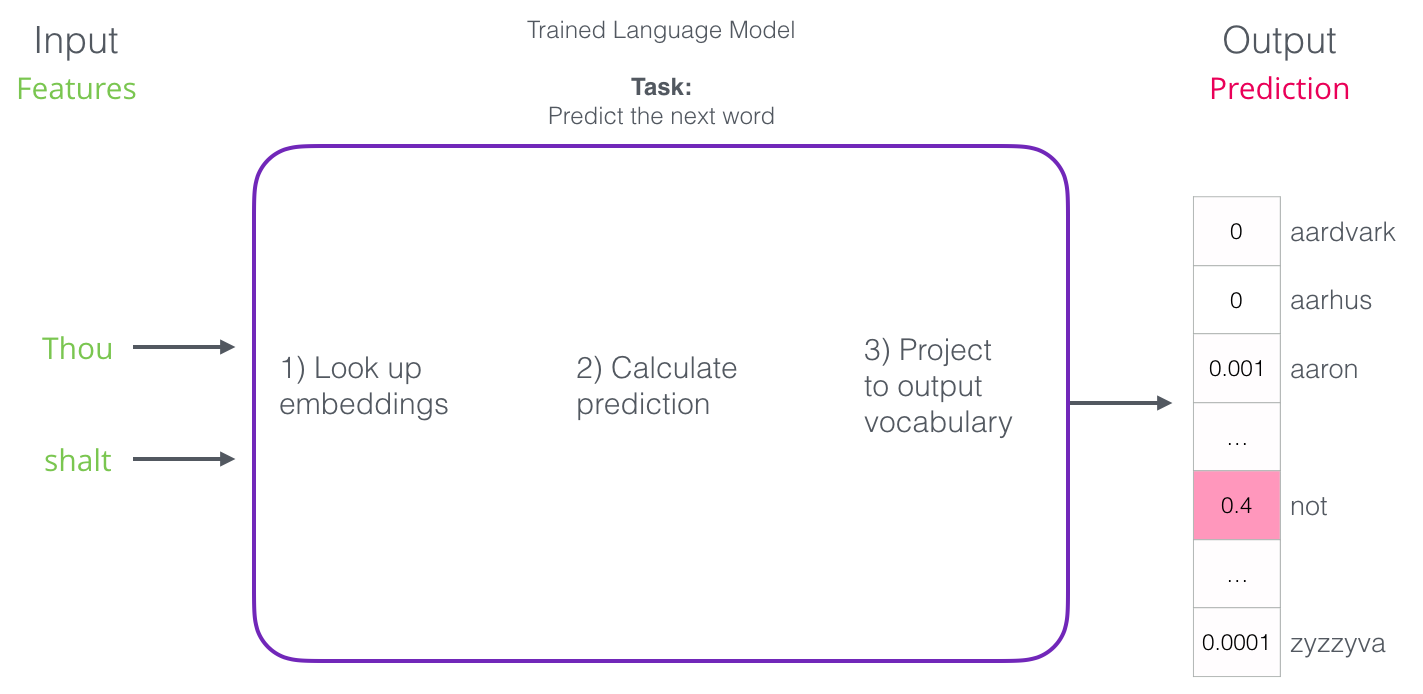
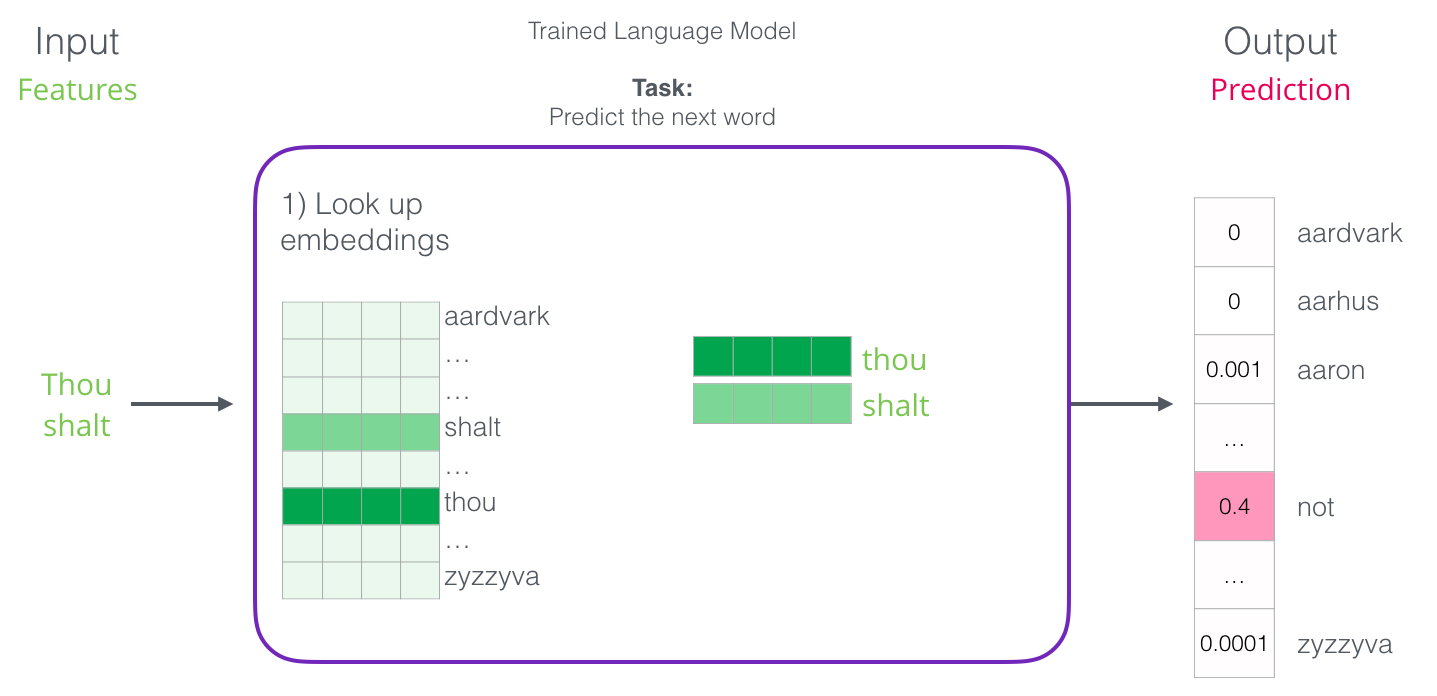
在我们讨论词嵌入时,第一步最为重要。训练过程的结果之一是这样一个矩阵,其中包含了词汇表中每个词的词嵌入。在预测时,我们只需查找输入词的词嵌入,并用它们来计算预测值:
现在让我们转向训练过程,以了解更多关于这个嵌入矩阵是如何开发的。
语言模型训练
“停止一个过程就无法理解它。理解必须顺应过程的流动,融入其中,与之共舞。”——《沙丘》
语言模型相比大多数其他机器学习模型具有巨大的优势。这个优势在于,我们可以利用海量的文本数据来训练它们。想想我们身边那些书籍、文章、维基百科内容以及其他形式的文本数据吧。相比之下,许多其他机器学习模型则需要人工设计的特征和专门收集的数据。
“从词语所处的语境就能判断其含义。”——JR·弗斯
我们通过观察词语通常与哪些其他词语相邻来获取词语的词嵌入。其机制如下:
- 我们获取了大量文本数据(例如,所有维基百科文章)。
- 我们有一个窗口(比如说三个词),我们可以把它滑动到所有文本上。
- 滑动窗口为我们的模型生成训练样本。
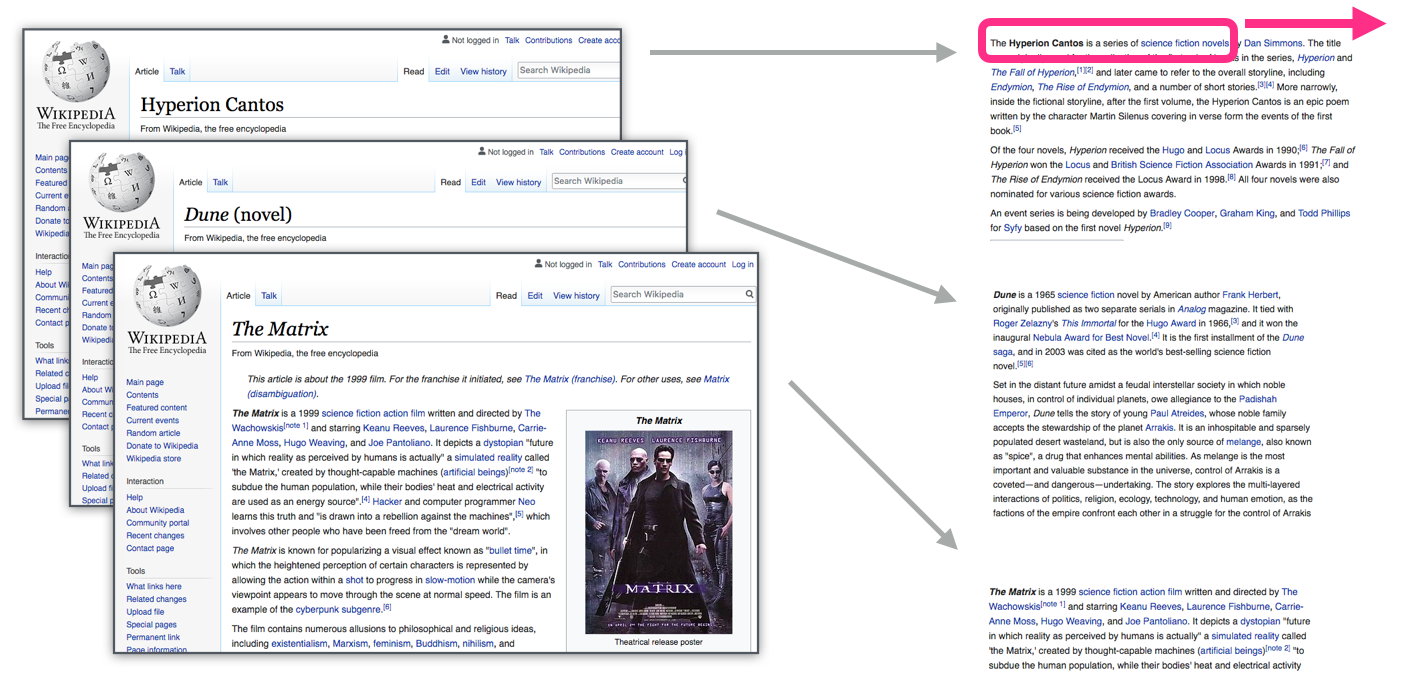
当这个窗口沿着文本滑动时,我们(虚拟地)生成了一个数据集,用于训练模型。为了更清楚地了解它是如何实现的,让我们看看滑动窗口是如何处理这个短语的:
“不可制造出形似人类心智的机器”~《沙丘》
开始时,窗口会显示在句子的前三个单词上:
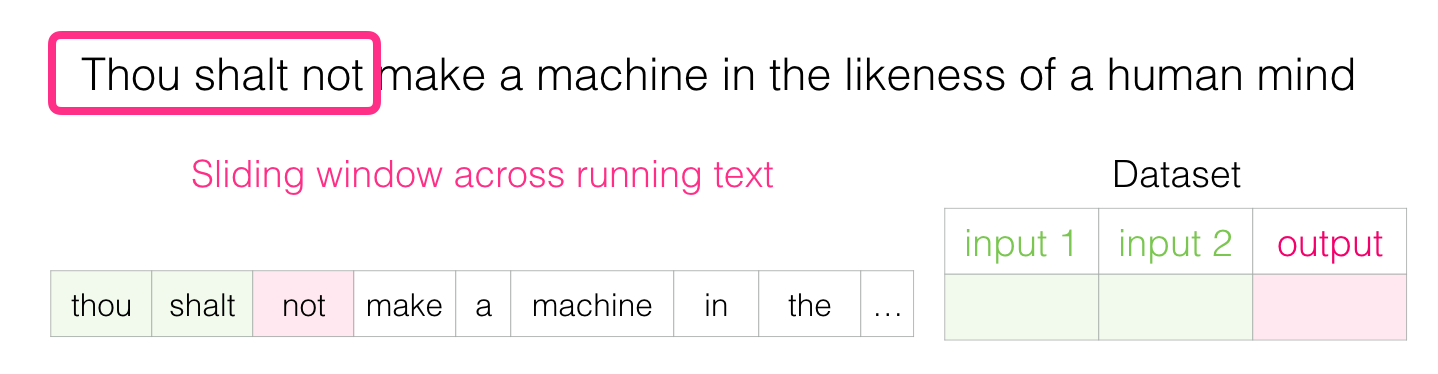
我们将前两个词视为特征,将第三个词视为标签:
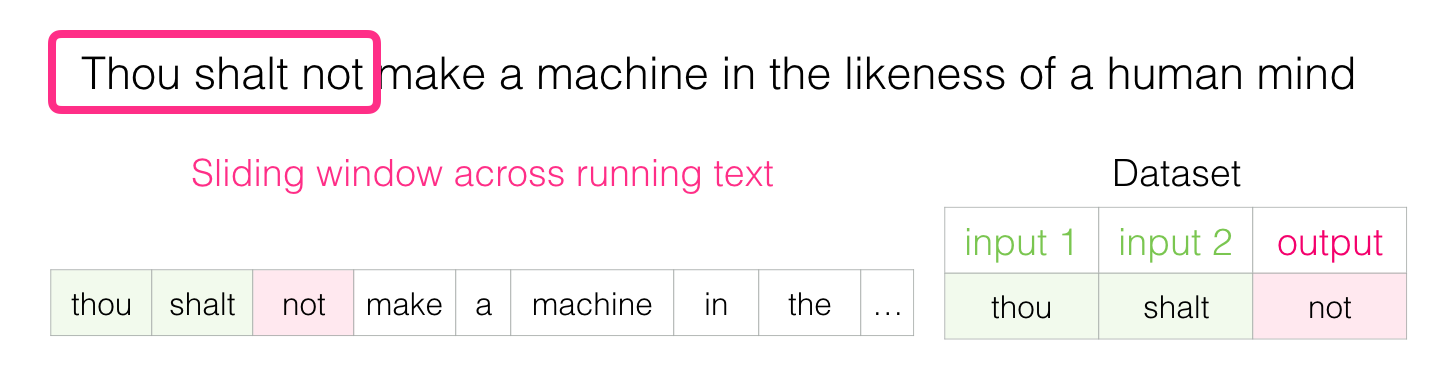
我们现在已经生成了数据集中的第一个样本,之后我们可以用它来训练语言模型。
然后我们将窗口滑动到下一个位置,创建第二个样本:
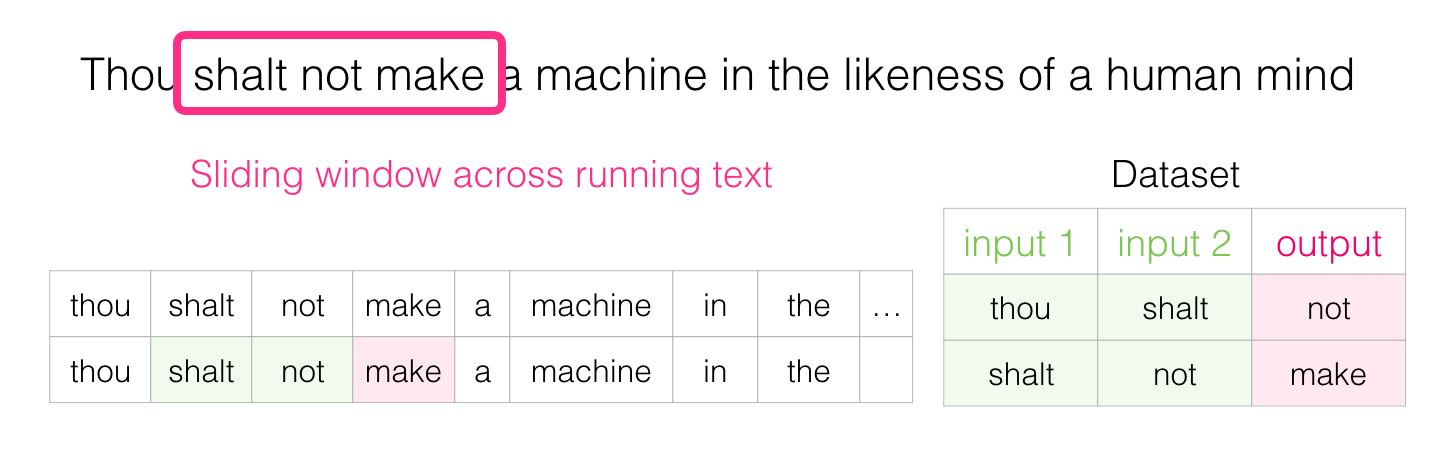
An the second example is now generated.
现在生成第二个示例。
很快,我们就得到了一个更大的数据集,其中记录了哪些词语倾向于出现在不同的词对之后:
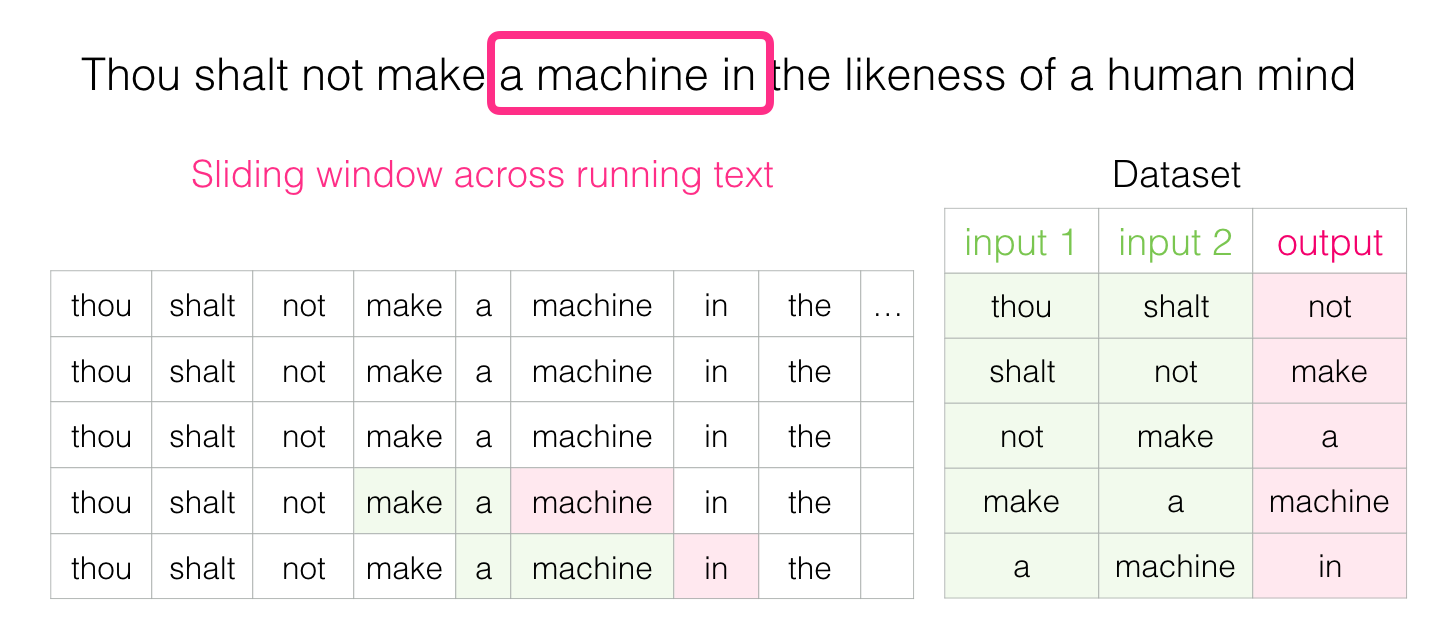
在实践中,模型通常会在我们滑动窗口的同时进行训练。但我认为将“数据集生成”阶段与训练阶段在逻辑上分开会更清晰。除了基于神经网络的语言建模方法之外,一种名为 N-gram 的技术也常用于训练语言模型(参见 《语音与语言处理 》第三章)。为了了解从 N-gram 到神经模型的转变如何影响实际产品, 这里引用一篇来自 Swiftkey(我最喜欢的安卓键盘)2015 年的博文 ,其中介绍了他们的神经语言模型,并将其与之前的 N-gram 模型进行了比较。我喜欢这个例子,因为它展示了如何用营销语言来描述词嵌入的算法特性。
左右看看
“悖论就像一个指针,指引你超越它。如果你被悖论困扰,那说明你内心深处渴望绝对真理。相对主义者则把悖论仅仅看作有趣的东西,或许令人发笑,甚至——尽管可怕——具有教育意义。”~《沙丘之神帝》
根据文章前面的内容,填空:
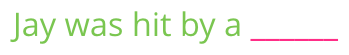
我给你的上下文是空格前五个词(以及之前提到的“bus”)。我相信大多数人都会猜空格里应该填“ bus ”。但是,如果我再给你一条信息——空格后的一个词,你的答案会改变吗?
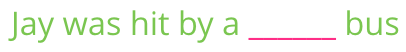
这彻底改变了空格处应该填什么。“ red ”现在最有可能填入空格。由此我们得知,某个特定词语前后的词语都包含信息价值。事实证明,同时考虑左右两侧的词语(即我们猜测的词语左右两侧的词语)可以得到更好的词嵌入。接下来,我们来看看如何调整模型的训练方式来解决这个问题。
Skipgram
“情报工作需要在数据有限的情况下冒险,在这个领域,犯错不仅可能发生,而且是必要的。” ~章节:沙丘
除了查看目标词前两个词之外,我们还可以查看目标词后两个词。
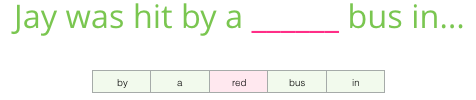
如果我们这样做,我们虚拟构建并用于训练模型的数据集将如下所示:
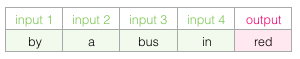
这被称为 连续词袋 架构,在 word2vec 的一篇论文 [pdf] 中有详细描述。另一种也往往表现出色、但实现方式略有不同的架构。
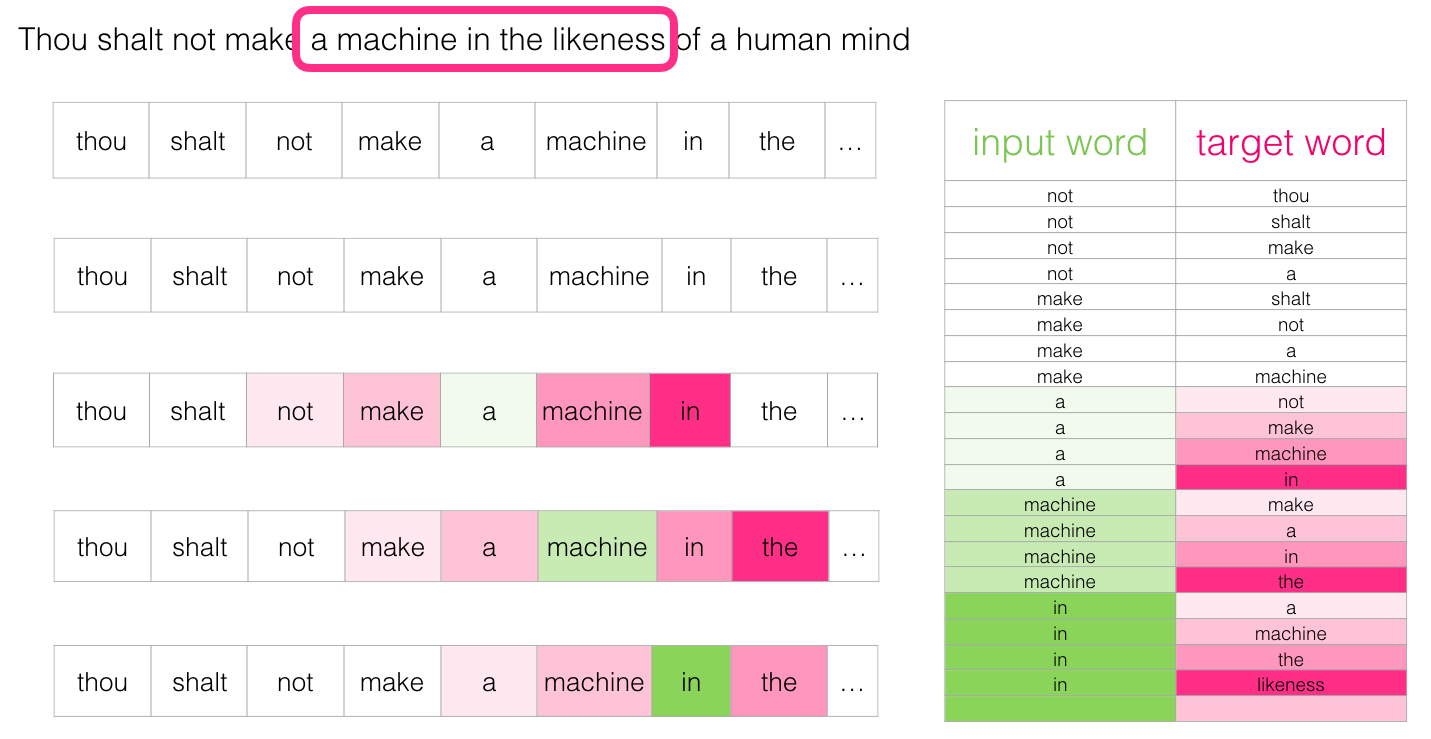
这种架构并非根据上下文(前后词)来猜测单词,而是尝试利用当前单词来猜测相邻的单词。我们可以把它想象成一个在训练文本上滑动的窗口,如下所示:
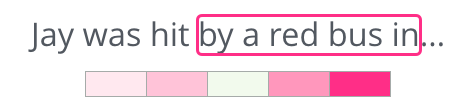
绿色格子里的单词是输入词,每个粉色方框代表一个可能的输出词。
粉色方框呈现不同的色调,是因为这个滑动窗口实际上在我们的训练数据集中创建了四个不同的样本:
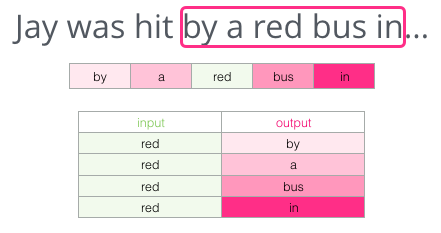
这种方法被称为 skipgram 架构。我们可以将滑动窗口可视化为执行以下操作:
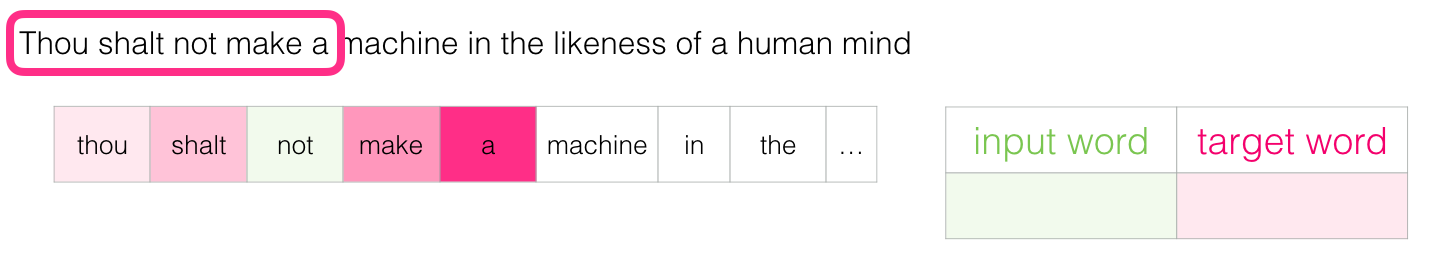
这将把这四个样本添加到我们的训练数据集中:
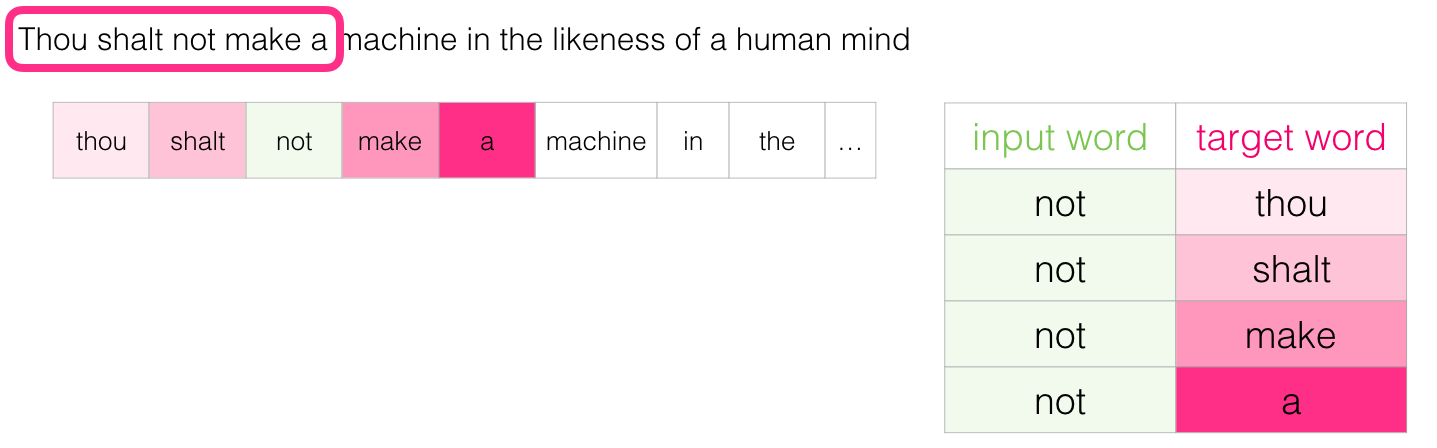
然后我们将窗口滑动到下一个位置:
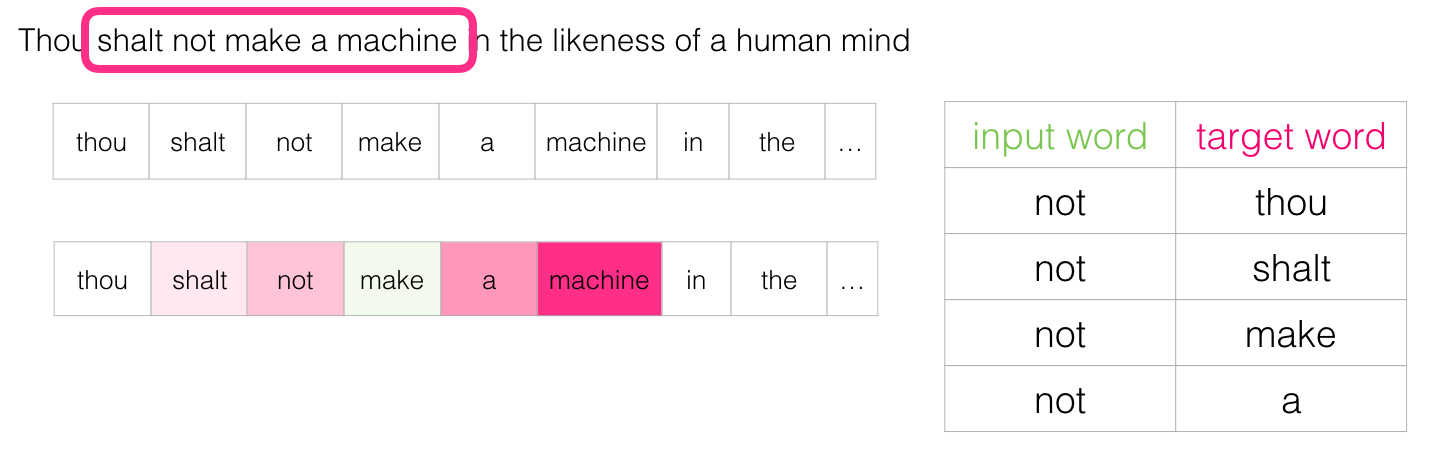
由此引出了我们接下来的四个例子:
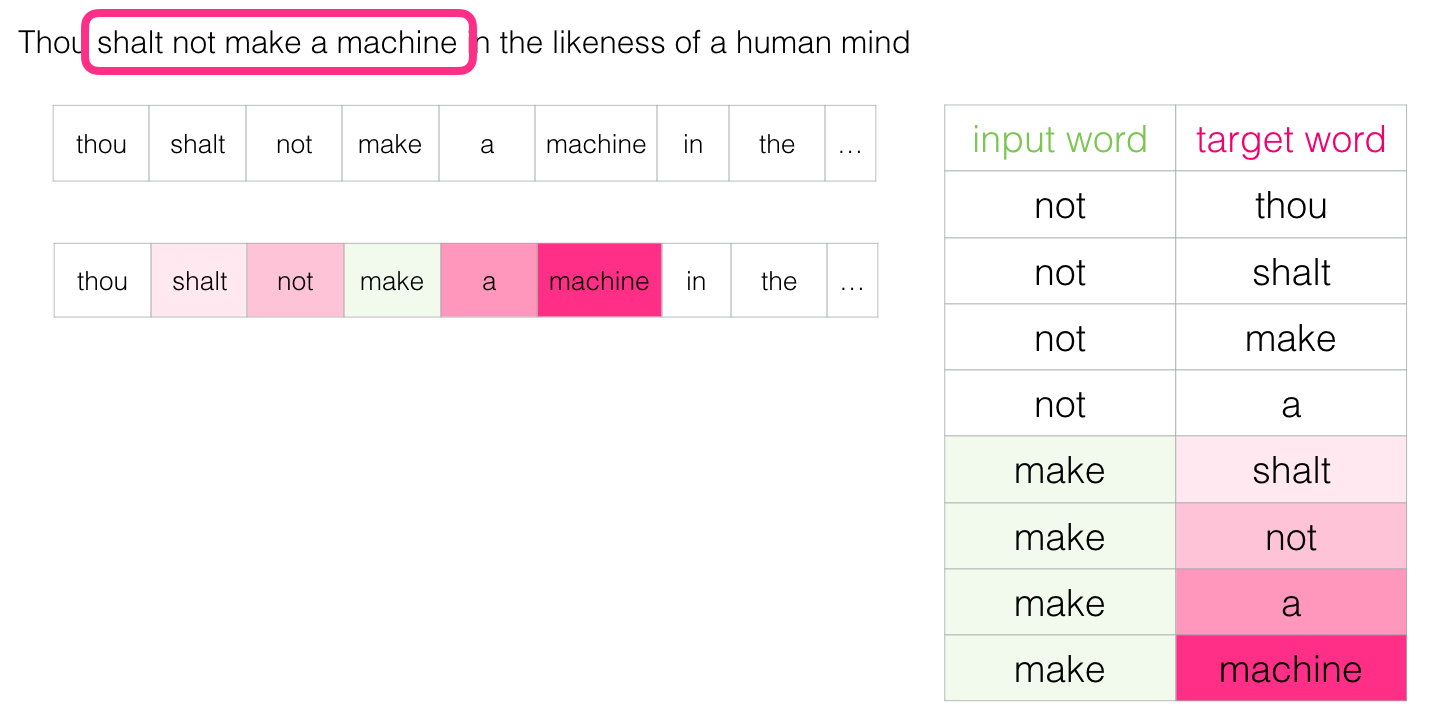
再过几个职位,我们就能看到更多例子:
重新审视培训过程
“穆阿迪布之所以学得如此迅速,是因为他首先接受的是如何学习的训练。而他接受的第一课,就是相信自己能够学会。令人震惊的是,竟然有那么多人不相信自己能够学会,还有更多的人认为学习是一件难事。”——《沙丘》
现在我们有了从现有文本中提取的 skipgram 训练数据集,让我们来看看如何用它来训练一个预测相邻单词的基本神经语言模型。
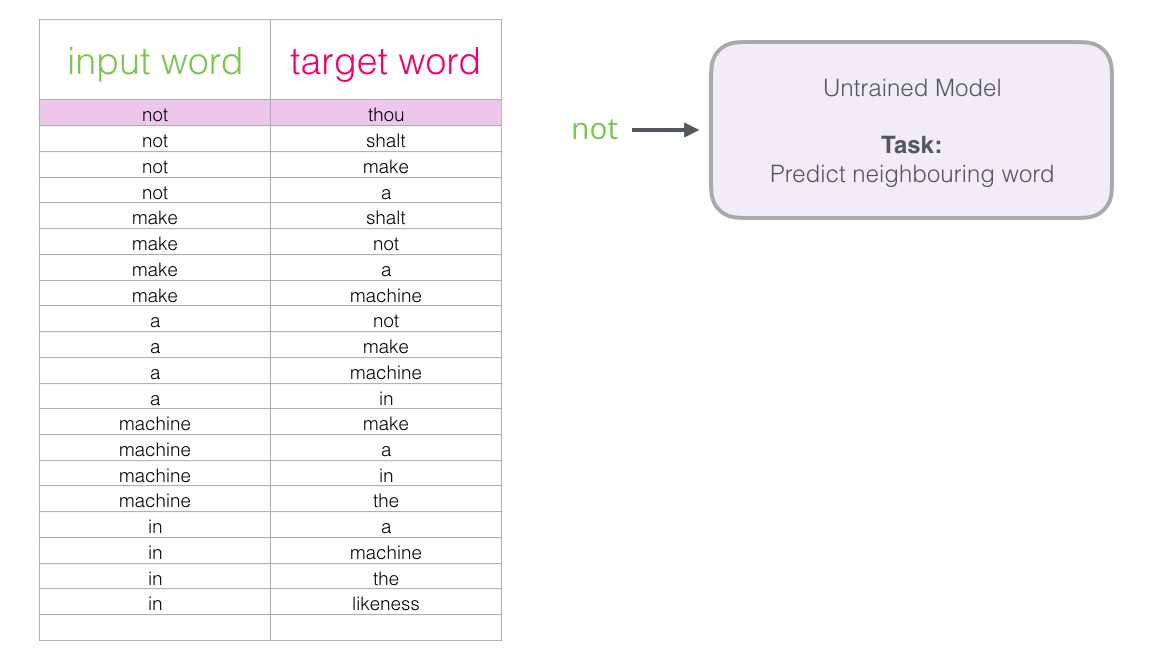
我们从数据集中的第一个样本开始。我们提取其特征,并将其输入到未经训练的模型中,要求它预测一个合适的邻近词。
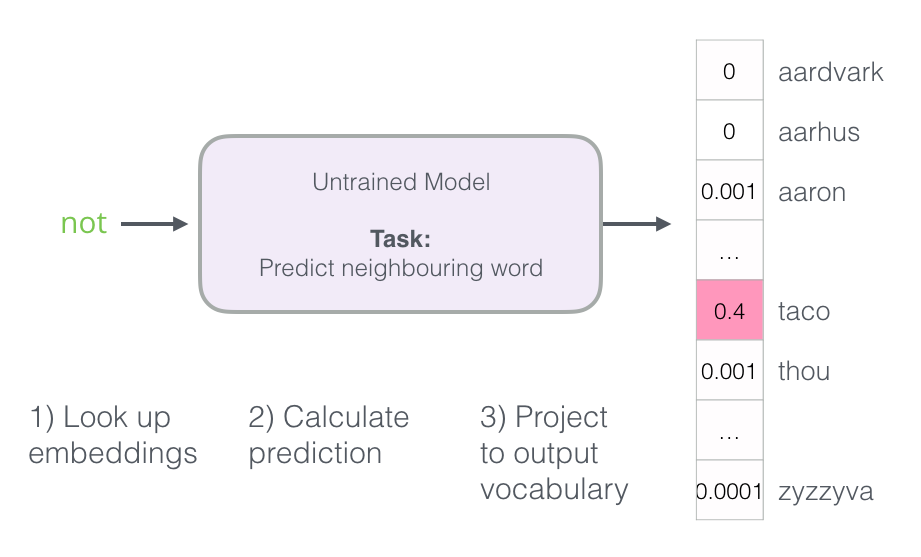
该模型执行这三个步骤,并输出一个预测向量(词汇表中的每个词都被赋予一个概率)。由于模型未经训练,因此在这个阶段它的预测肯定是错误的。但这没关系。我们知道它应该猜对哪个词——即我们当前用于训练模型的行中的标签/输出单元格:
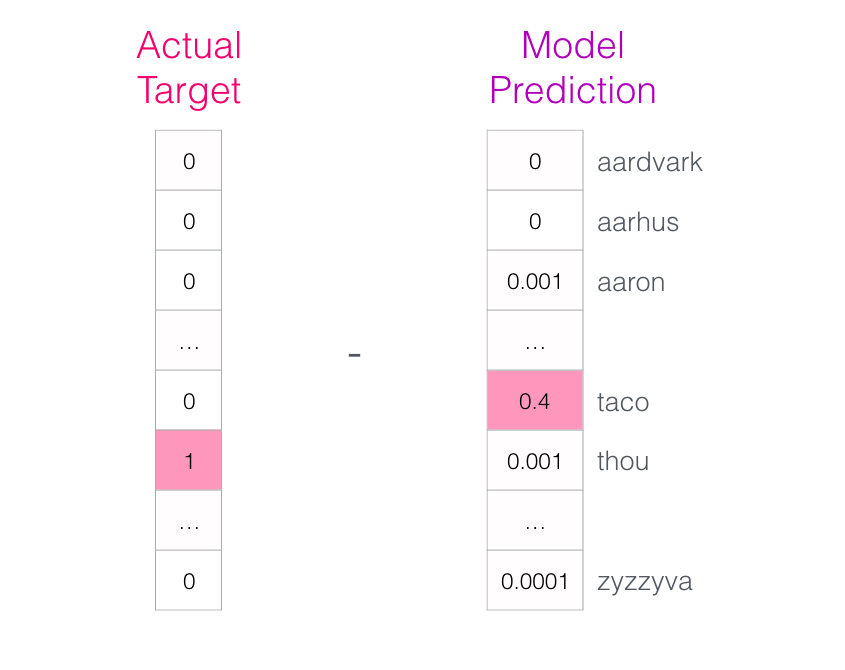
“目标向量”是指目标词的概率为 1,所有其他词的概率为 0 的向量。
模型偏差有多大?我们将两个向量相减,得到误差向量:
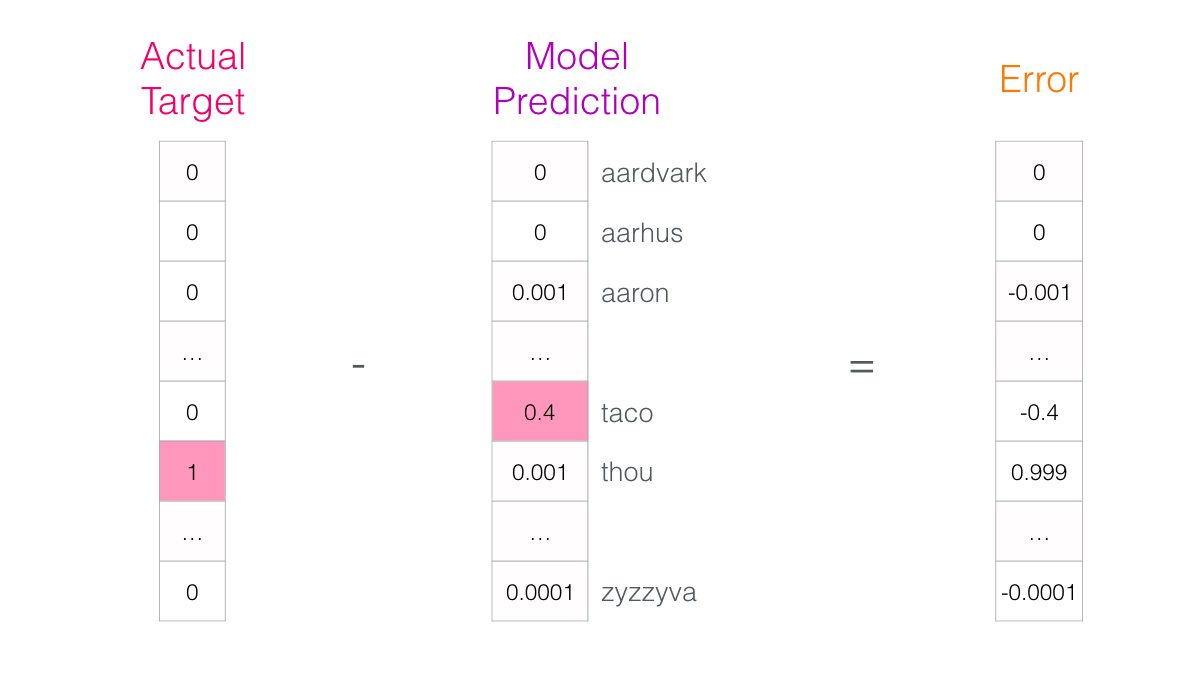
现在可以使用这个误差向量来更新模型,以便下次当输入 not 预期值时,模型更有可能做出 thou 判断。
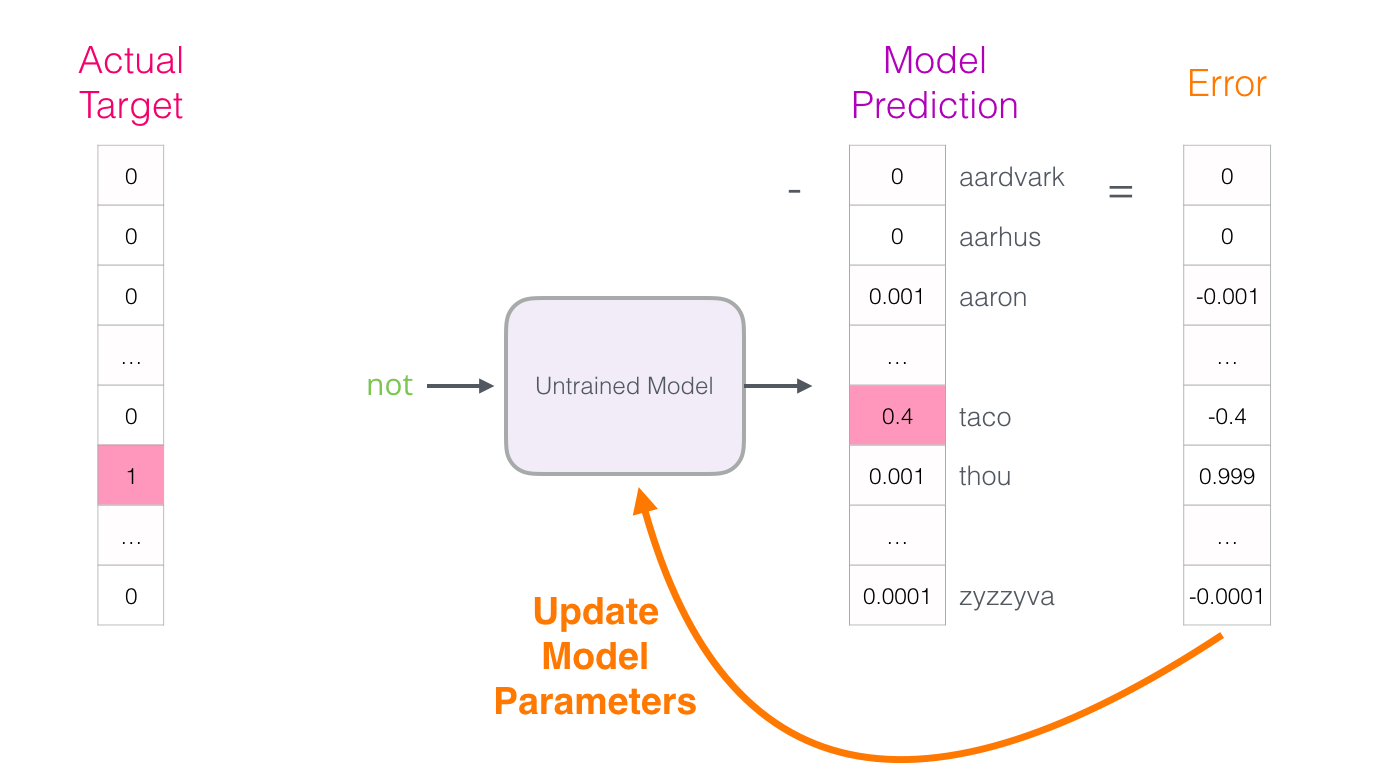
训练的第一步到此结束。接下来,我们对数据集中的下一个样本重复上述步骤,直到覆盖数据集中的所有样本。这样就完成了一个训练 周期 。我们重复这个过程若干个周期,最终得到训练好的模型,并从中提取嵌入矩阵,用于其他应用。
虽然这加深了我们对该过程的理解,但这仍然不是 word2vec 实际的训练方式。我们仍然缺少一些关键概念。
负抽样
“若不了解穆阿迪布的死敌哈克南家族,就试图理解他,就好比不了解谬误,就试图看清真理;不了解黑暗,就试图看到光明。这是不可能的。”——《沙丘》
回顾一下这个神经语言模型计算预测结果的三个步骤:
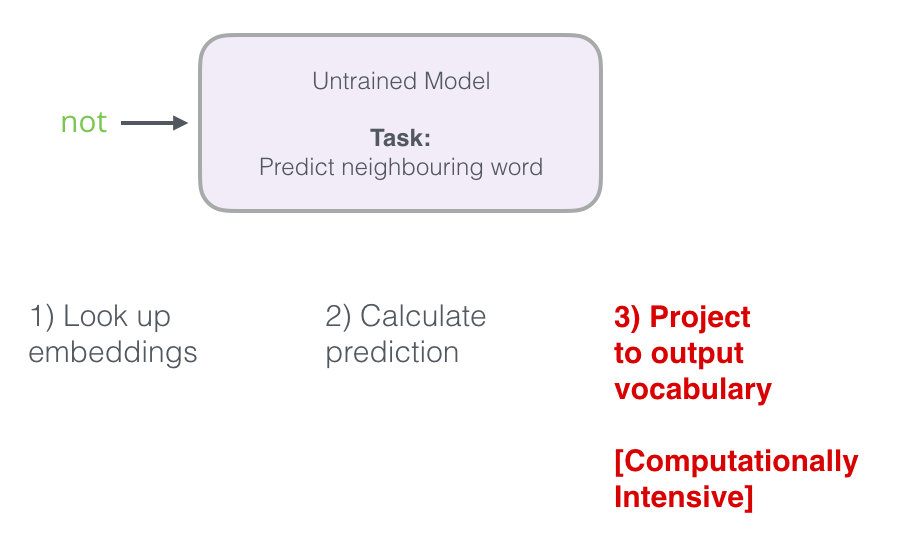
第三步的计算成本非常高——尤其是在考虑到我们需要对数据集中的每个训练样本执行一次这一步(很容易达到数千万次)的情况下。我们需要采取一些措施来提高性能。
一种方法是将我们的目标分成两个步骤:
- 生成高质量的词嵌入(无需担心下一个词的预测)。
- 使用这些高质量的词嵌入来训练语言模型(进行下一个词预测)。
本文将重点讨论步骤 1,因为我们主要关注词嵌入。为了使用高性能模型生成高质量的词嵌入,我们可以将模型的任务从预测相邻词切换为:
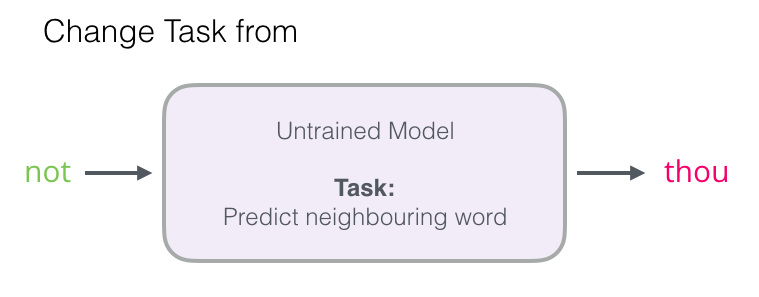
并将其切换为接受输入词和输出词的模型,并输出一个分数,指示它们是否为邻居(0 表示“不是邻居”,1 表示“邻居”)。
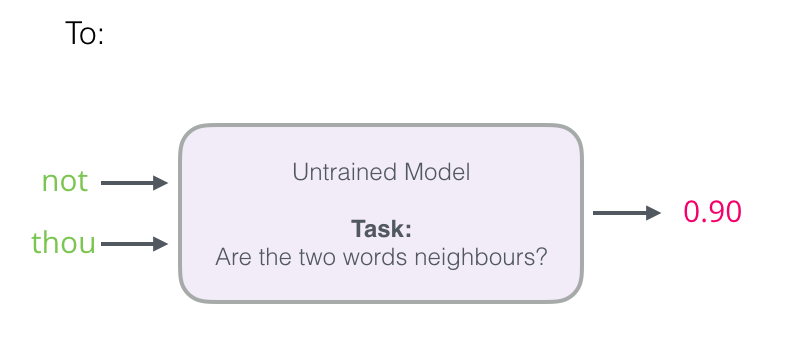
这个简单的切换将我们需要的模型从神经网络模型更改为逻辑回归模型——因此计算变得更加简单快捷。
这种切换需要我们改变数据集的结构——标签现在是一个新的列,值为 0 或 1。由于我们添加的所有单词都是相邻的,所以它们的值都将是 1。
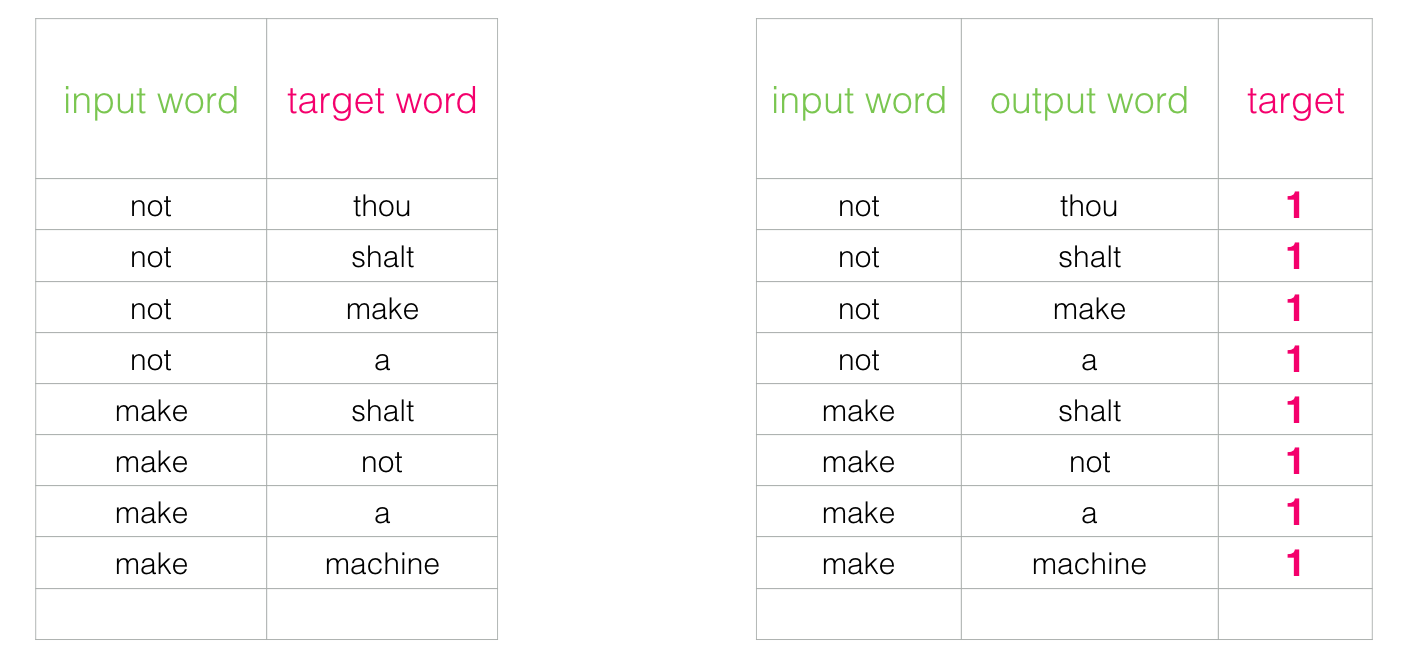
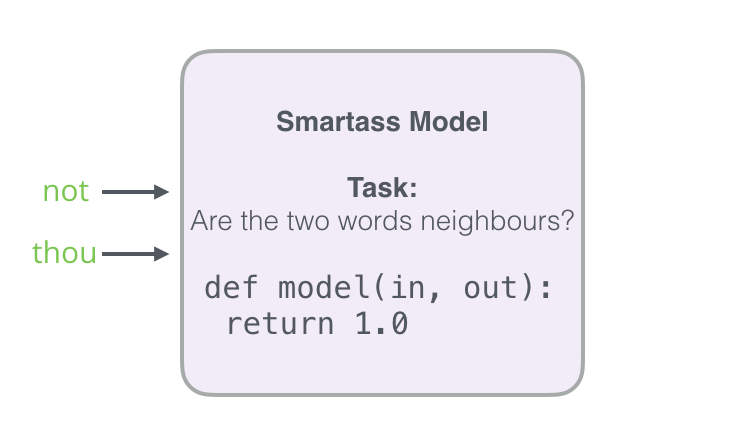
现在,我们可以以惊人的速度进行计算——几分钟内即可处理数百万个样本。但我们需要堵上一个漏洞。如果所有样本都是正例(目标值:1),我们就可能遇到一个“聪明”的模型,它总是返回 1——虽然准确率达到 100%,但却什么也没学到,生成的都是垃圾嵌入。
为了解决这个问题,我们需要在数据集中引入 负样本 ——即词与单词不相邻的样本。我们的模型需要对这些样本返回 0。这无疑是一个挑战,模型需要付出巨大的努力才能解决——但速度依然非常快。
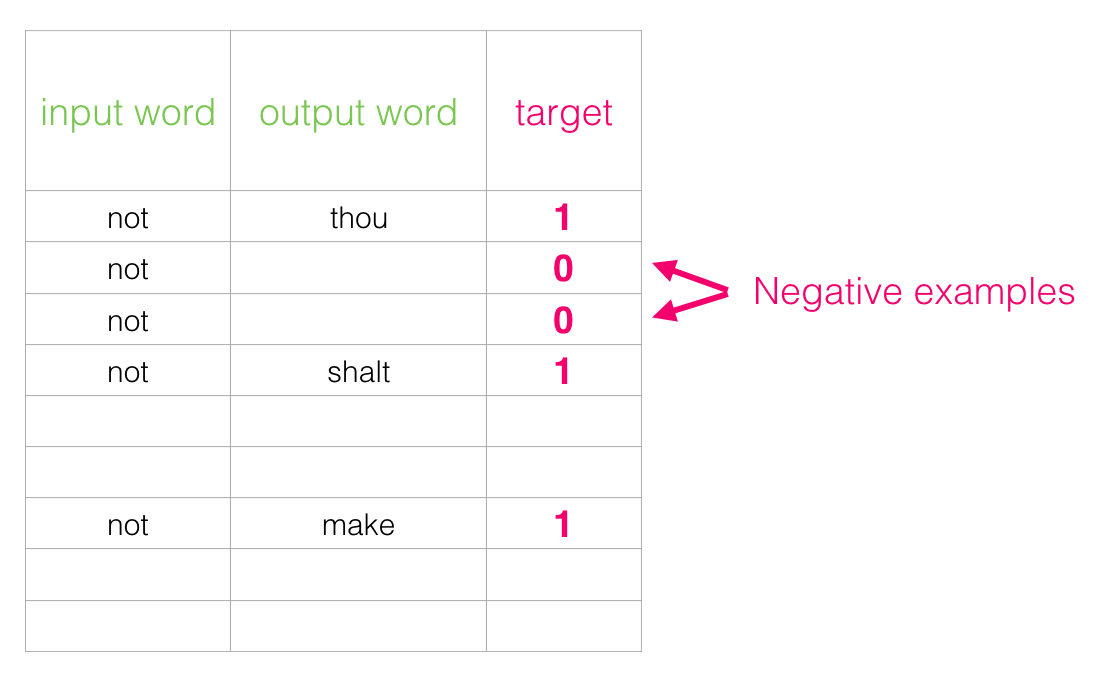
对于数据集中的每个样本,我们都添加了 反例 。这些反例具有相同的输入词,但标签为 0。
但是,我们应该用什么词来填充输出词呢?我们从词汇表中随机抽取一些词。
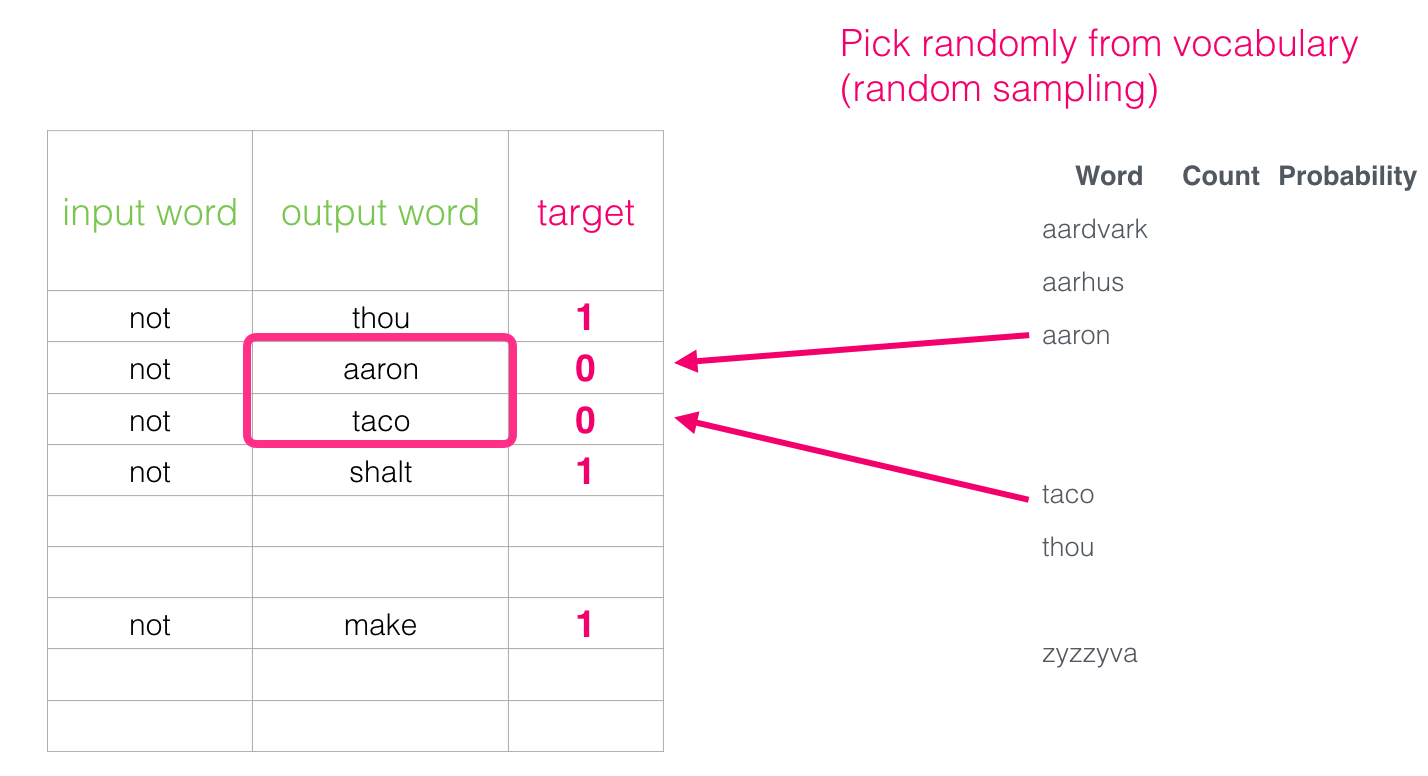
这个想法源于 噪声对比估计 [pdf]。我们将实际信号(相邻词的正例)与噪声(随机选择的、非相邻词)进行对比。这在计算效率和统计效率之间取得了很好的平衡。
Skipgram with negative sampleling (SGNS)
我们现在已经介绍了 word2vec 中的两个核心思想:它们成对出现,被称为带有负采样的 skipgram。
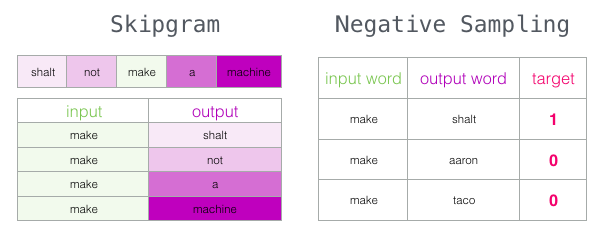
Word2vec 训练过程
“机器无法预见对人类而言重要的每一个问题。这就好比串行比特和不间断的连续体之间的区别。我们拥有前者;机器则受限于后者。”——《沙丘之神帝》
现在我们已经确定了 skipgram 和负采样这两个核心概念,我们可以继续更仔细地研究 word2vec 的实际训练过程。
在训练过程开始之前,我们会对用于训练模型的文本进行预处理。在这一步中,我们会确定词汇表的大小(我们称之为 vocab_size ,例如,可以将其视为 10,000 个单词)以及哪些单词属于该词汇表。
在训练阶段开始时,我们创建两个矩阵—— Embedding 矩阵和 Context 矩阵。这两个矩阵分别包含词汇表中的每个词的嵌入向量(因此 vocab_size 是它们的一个维度)。第二个维度是我们希望每个嵌入向量的长度( embedding_size - 300 是一个常用值,但我们在本文前面已经讨论过 50 的例子)。
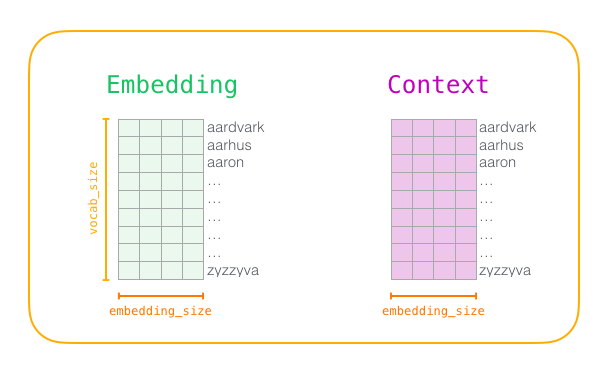
在训练过程开始时,我们用随机值初始化这些矩阵。然后开始训练过程。在每个训练步骤中,我们选取一个正样本及其对应的负样本。让我们来看第一组样本:
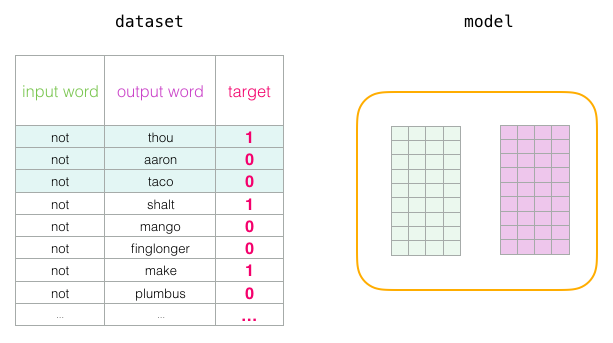
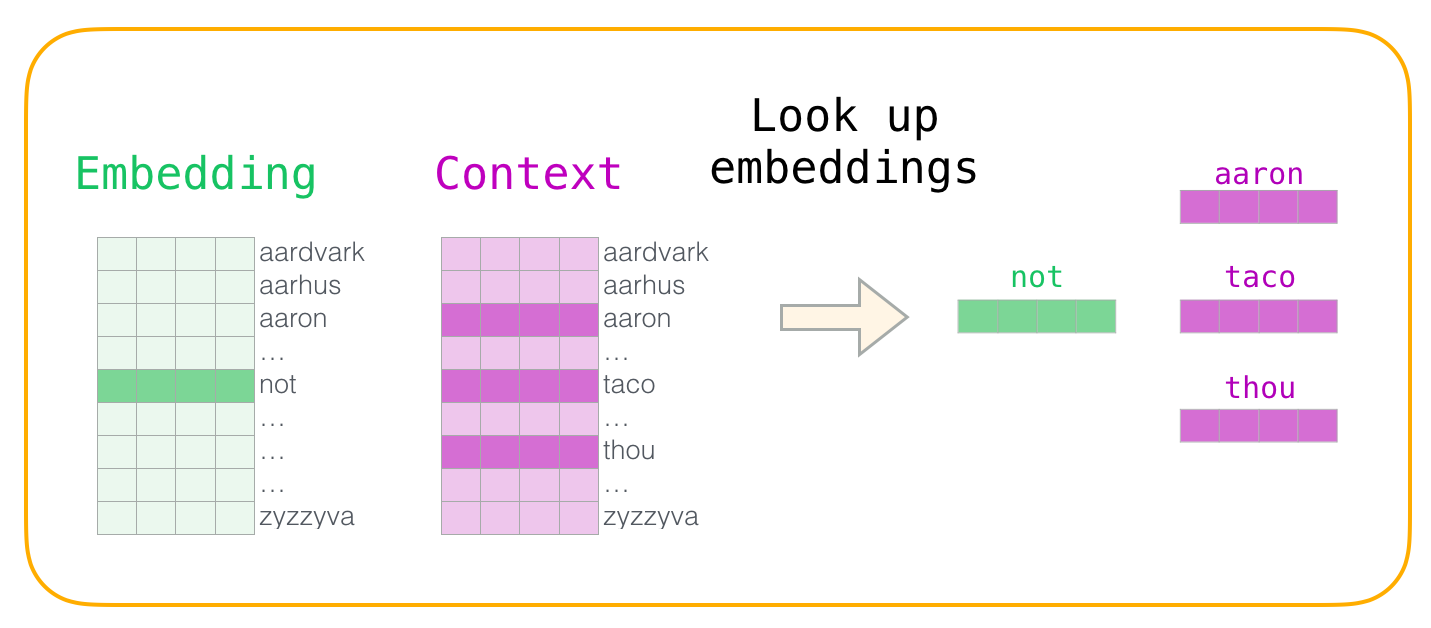
Now we have four words: the input word not and output/context words: thou (the actual neighbor), aaron, and taco (the negative examples). We proceed to look up their embeddings – for the input word, we look in the Embedding matrix. For the context words, we look in the Context matrix (even though both matrices have an embedding for every word in our vocabulary).
现在我们有四个词:输入词 not 和输出/上下文词: thou (实际的邻近词)、 aaron 和 taco (反例)。接下来,我们查找它们的词嵌入——对于输入词,我们在词 Embedding 矩阵中查找。对于上下文词,我们在 Context 矩阵中查找(尽管两个矩阵都包含了词汇表中的每个词的词嵌入)。
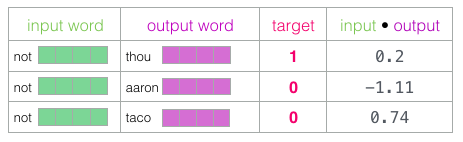
然后,我们将输入嵌入与每个上下文嵌入进行点积运算。在每种情况下,结果都会是一个数值,该数值表示输入嵌入和上下文嵌入的相似度。
现在我们需要一种方法将这些分数转换成类似概率的形式——我们需要它们全部为正数,且取值范围在 0 到 1 之间。这正是 逻辑运算 sigmoid 函数 的用武之地。
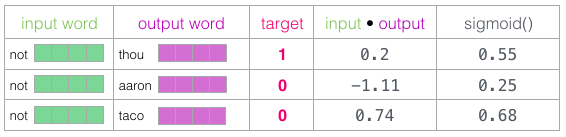
现在我们可以将 sigmoid 函数运算的输出视为这些示例中模型的输出。可以看到,无论在 sigmoid 函数运算前后, taco 得分始终最高,而 aaron 得分始终最低。
现在未经训练的模型已经做出了预测,而且我们有了实际的目标标签可以用来比较,接下来让我们计算模型预测的误差。为此,我们只需从目标标签中减去 sigmoid 函数的得分即可。
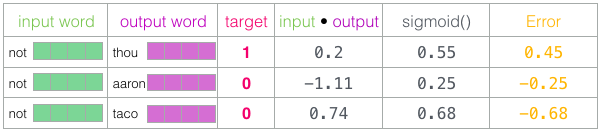
error = target - sigmoid_scores
接下来就是“机器学习”中的“学习”部分了。我们现在可以利用这个误差分数来调整 not 、 thou 、 aaron 和 taco 的词嵌入,以便下次进行此计算时,结果能够更接近目标分数。
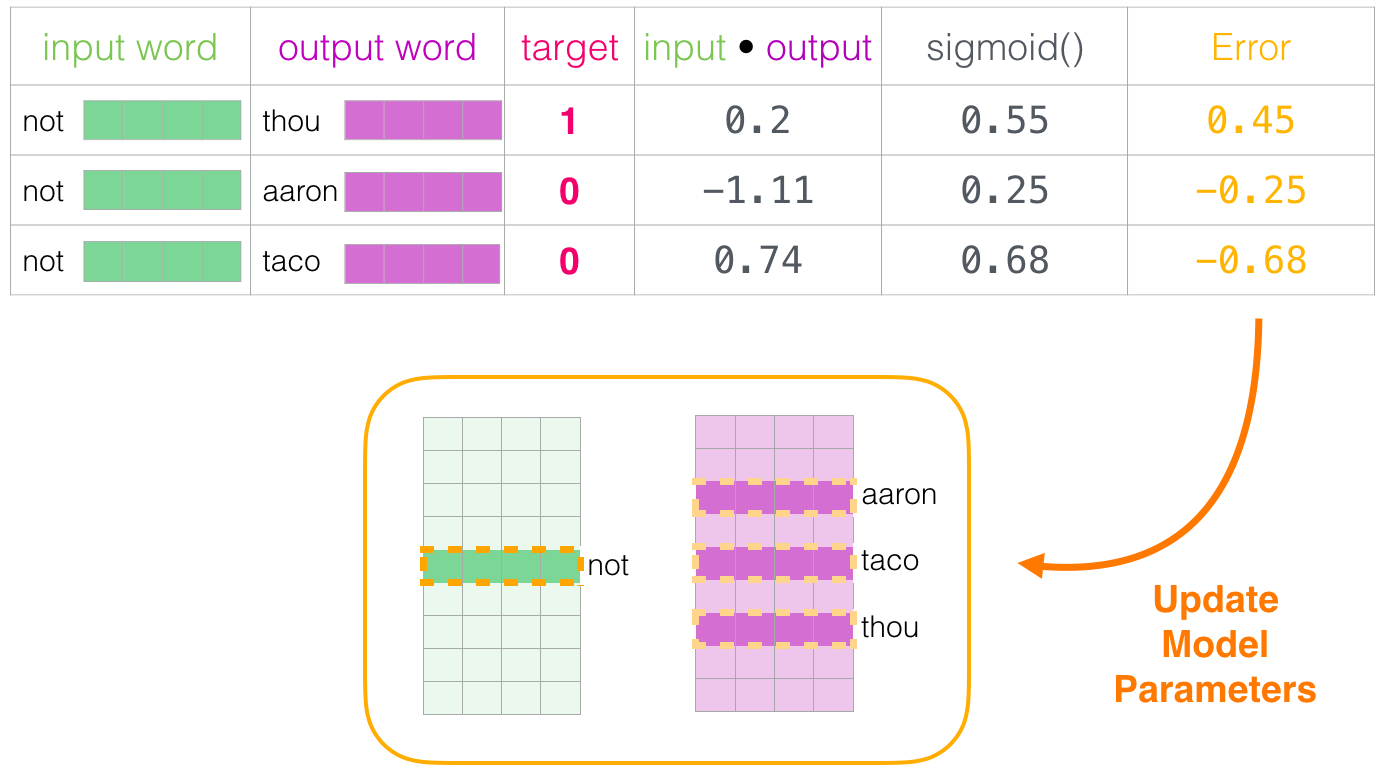
训练步骤到此结束。我们得到了略微改进的词嵌入,这些词包括: not 、 thou 、 aaron 和 taco 。现在我们进入下一步(下一个正样本及其对应的负样本),并重复上述过程。
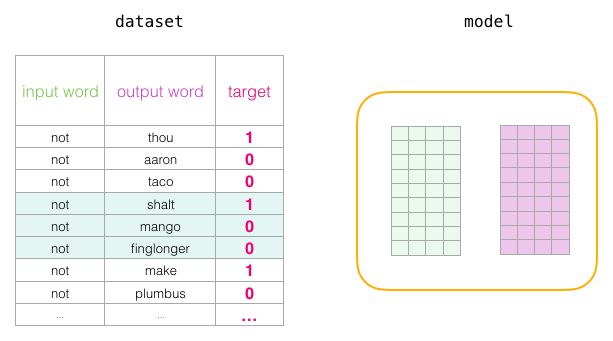
在多次遍历整个数据集的过程中,词嵌入会不断改进。之后,我们可以停止训练过程,丢弃 Context 矩阵,并将 Embeddings 矩阵用作下一个任务的预训练词嵌入。
Window Size and Number of Negative Samples窗口大小和负样本数量
word2vec 训练过程中的两个关键超参数是窗口大小和负样本数量。
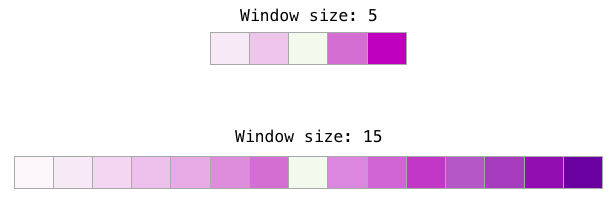
不同的任务需要不同的窗口大小才能更好地完成。一种 经验法则 是,较小的窗口大小(2-15)会导致词嵌入中两个词嵌入之间的相似度得分较高,这表明这两个词可以 互换 (注意,如果我们只考虑它们的上下文,反义词通常可以互换——例如, “好” 和 “坏” 经常出现在相似的语境中)。较大的窗口大小(15-50,甚至更大)会导致词嵌入中的相似度更多地反映词语之间的 相关性 。在实践中,您通常需要提供 标注 来指导词嵌入过程,从而获得适合您任务的有效相似度信息。Gensim 的默认窗口大小为 5(除了输入词本身之外,输入词前后各五个词)。
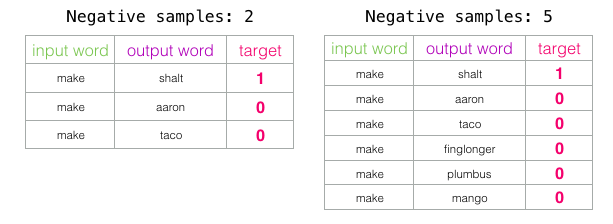
负样本的数量是训练过程中的另一个重要因素。原始论文建议负样本数量为 5-20 个。论文还指出,当数据集足够大时,2-5 个负样本似乎也足够了。Gensim 的默认值为 5 个负样本。
Conclusion 结论
“如果它超出了你的衡量标准,那么你面对的是智慧,而非自动化。”——《沙丘之神帝》
我希望你现在对词嵌入和 word2vec 算法有了一定的了解。我也希望,当你阅读到提到“带负采样的 skip-gram 模型”(SGNS)的论文(例如前面提到的推荐系统论文)时,你能更好地理解这些概念。一如既往,欢迎 @JayAlammar 提供任何反馈。
参考文献及延伸阅读
- Distributed Representations of Words and Phrases and their Compositionality
- 词语和短语的分布式表示及其组合性
- Efficient Estimation of Word Representations in Vector Space
- 向量空间中词表示的高效估计
- A Neural Probabilistic Language Model
- 神经概率语言模型
- Speech and Language Processing by Dan Jurafsky and James H. Martin is a leading resource for NLP. Word2vec is tackled in Chapter 6.
- Dan Jurafsky 和 James H. Martin 合著的 《语音与语言处理》 是自然语言处理领域的权威著作。Word2vec 算法在第六章进行了讲解。
- Neural Network Methods in Natural Language Processing by Yoav Goldberg is a great read for neural NLP topics.
- Yoav Goldberg 的《 自然语言处理中的神经网络方法》 是一本关于神经自然语言处理主题的优秀读物。
- Chris McCormick has written some great blog posts about Word2vec. He also just released The Inner Workings of word2vec, an E-book focused on the internals of word2vec.
- Chris McCormick 写了一些关于 Word2vec 的很棒的博客文章。他还刚刚发布了 《Word2vec 的内部运作》 ,这是一本专注于 Word2vec 内部机制的电子书。
- Want to read the code? Here are two options:
想查看代码吗?这里有两种选择: - Gensim’s python implementation of word2vec
- Gensim 的 word2vec 的 Python 实现
- Mikolov’s original implementation in C – better yet, this version with detailed comments from Chris McCormick.
- Mikolov 的 C 语言原始实现 ——更好的是,这个 版本有 Chris McCormick 的详细注释 。
- Evaluating distributional models of compositional semantics
评估组合语义的分布模型 - On word embeddings, part 2
- 关于词嵌入 ,第二部分
- Dune 沙丘