
本文翻译自: https://writings.stephenwolfram.com/2023/02/what-is-chatgpt-doing-and-why-does-it-work/
ChatGPT 能够自动生成哪怕表面上看起来像人类撰写的文本,这令人惊叹,也出乎意料。但它是如何做到的?为什么它能做到这一点?本文旨在概述 ChatGPT 的内部运作机制,并探讨它为何能够如此出色地生成我们认为有意义的文本。首先需要说明的是,我将着重于整体框架的阐述——虽然我会提及一些技术细节,但不会深入探讨。(而且,我接下来要讲的内容同样适用于其他现有的“大型语言模型”。)
首先要解释的是,ChatGPT 从根本上来说,始终试图生成它目前为止所拥有的任何文本的“合理延续”,其中“合理”指的是“在看到人们在数十亿个网页上写的内容之后,人们可能会期望写出的内容等等”。
假设我们有这样一段文字:“ 人工智能最棒的地方在于它能够…… ”。想象一下,扫描数十亿页人类撰写的文本(例如网络上的文本和数字化书籍),找到所有出现这段文字的地方,然后统计接下来出现的词语及其出现的概率。ChatGPT 实际上就是做类似的事情,只不过(正如我将要解释的)它并不直接分析文本的字面意思;它寻找的是某种意义上“含义相符”的内容。最终,它会生成一个可能紧随其后的词语列表,并附上相应的“概率”:

更神奇的是,当 ChatGPT 执行诸如写文章之类的任务时,它本质上只是反复询问“根据目前为止的文本,下一个词应该是什么?”——每次都添加一个词。(更准确地说,正如我将要解释的,它添加的是一个“词元”,而词元可能只是一个词的一部分,这就是为什么它有时可以“创造新词”。)
好吧,每一步它都会得到一个包含概率的单词列表。但它究竟应该选择哪个词添加到它正在撰写的文章(或其他内容)中呢?人们可能会认为它应该选择“排名最高”的词(即被赋予最高“概率”的词)。但这里就有点玄乎了。因为出于某种原因——也许有一天我们会用科学的方法解释——如果我们总是选择排名最高的词,通常会得到一篇非常“平淡”的文章,似乎“没有任何创意”(甚至有时还会逐字重复)。但如果我们有时(随机地)选择排名较低的词,就会得到一篇“更有趣”的文章。
这里的随机性意味着,如果我们多次使用相同的提示,每次都可能得到不同的文章。而且,为了符合某种神秘感,还有一个所谓的“温度”参数,它决定了低排名词语的使用频率。对于文章生成而言,0.8 的“温度”似乎是最佳选择。(值得强调的是,这里并没有使用任何“理论”;这只是实践中发现有效的方法。例如,“温度”的概念之所以存在,是因为我们恰好使用了 统计物理学中常见的 指数分布,但这之间并没有任何“物理”联系——至少就我们目前所知。)
在继续之前,我应该解释一下,为了便于讲解,我通常不会使用 ChatGPT 中的完整系统 ;相反,我通常会使用一个更简单的 GPT-2 系统 ,它的优点在于体积小巧,可以在标准的台式电脑上运行。因此,对于我展示的几乎所有内容,我都可以提供可以直接在电脑上运行的 Wolfram 语言 代码。(点击此处任意图片即可复制其背后的代码。)
例如,以下是如何获取上述概率表的方法。首先,我们需要 获取底层“语言模型”神经网络 :
稍后我们会深入研究这个神经网络,并讨论它的工作原理。但现在我们可以先把这个“网络模型”当作一个黑盒,应用到我们目前为止的文本上,并询问模型认为接下来最有可能出现的5个词:

这会将结果转换成一个格式明确的“ 数据集 ”:

如果反复“应用该模型”,就会发生以下情况——每一步都添加概率最高的词(在本代码中指定为模型的“决策”):

如果持续更长时间会发生什么?在这种情况下(“零温度”),很快就会出现混乱和重复的内容:

但是,如果不是总是选择“最佳”词,而是偶尔随机选择“非最佳”词(“随机性”对应于“温度”0.8),会怎么样呢?同样,我们可以构建文本:

每次执行此操作,都会做出不同的随机选择,文本内容也会有所不同——如下 5 个示例所示:

值得指出的是,即使在第一步,也有很多可能的“下一个词”可供选择(温度为 0.8),尽管它们的概率下降得很快(是的,此双对数图上的直线对应于 n –1 “幂律”衰减,这是语言一般统计特征的典型表现 ):

如果这种情况持续更长时间会发生什么?举个例子。这比第一个词(零温度)的情况要好一些,但充其量也只是有点奇怪:

这是使用 最简单的 GPT-2 模型 (2019 年版本)完成的。使用更新、 更强大的 GPT-3 模型,结果更好。以下是使用相同的“提示”,但使用最强大的 GPT-3 模型生成的顶级词(零度温度)文本:

以下是一个“温度为 0.8”的随机示例:

概率从何而来?
好的,ChatGPT 总是根据概率选择下一个单词。但是这些概率从何而来呢?我们先从一个更简单的问题入手。假设我们一次生成一个字母(而不是一个单词),那么如何计算每个字母的概率呢?
我们可以做的最简单的事情就是选取一段英文文本样本,然后计算不同字母在其中出现的频率。例如, 以下代码统计了维基百科“猫”条目中的字母数量 :

这对“狗”也同样适用:

结果相似,但并不完全相同(“o”在“dogs”文章中无疑更常见,毕竟它出现在单词“dog”本身中)。不过,如果我们选取足够多的英文文本样本,最终应该能够得到至少相当一致的结果:

如果我们按照这些概率生成一个字母序列,就会得到以下示例:

我们可以通过按一定概率添加空格(就像添加字母一样)来将其分解成“单词”:

我们可以通过强制“词长”分布与英语中的分布保持一致,来更好地生成“词”:

我们这里并没有得到任何“真正的单词”,但结果看起来略有好转。不过,要想更进一步,我们不能仅仅随机选择每个字母。例如,我们知道如果有一个字母“q”,那么下一个字母基本上一定是“u”。
以下是单个字母出现的概率图:
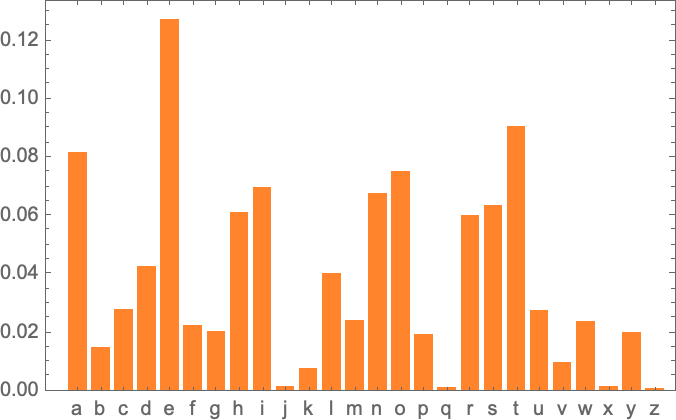
下图展示了典型英文文本中字母对(“2-gram”)的概率。可能的首字母显示在页面的横向,第二个字母显示在页面的纵向:

例如,我们可以看到,除了“u”行之外,“q”列都是空白(概率为零)。好的,现在我们不再一次生成一个字母的“单词”,而是每次考虑两个字母,使用这些“二元语法”概率来生成它们。以下是结果示例——其中包含一些“实际单词”:

只要有足够多的英文文本,我们不仅可以对单个字母或字母对(二元语法)的概率进行相当准确的估计,还可以对更长的字母序列的概率进行相当准确的估计。如果我们生成具有逐渐增加的 n 元语法概率的“随机词”,我们会发现它们变得越来越“真实”:

但现在我们假设——大致就像 ChatGPT 那样——我们处理的是完整的单词,而不是字母。 英语中大约有 4 万个比较常用的单词 。通过查看一个大型英语文本语料库(比如几百万本书,总共几千亿个单词),我们可以 估算出每个单词的常用程度 。利用这个估算值,我们可以开始生成“句子”,其中每个单词都是独立随机选择的,并且每个单词出现的概率与它在语料库中出现的概率相同。以下是我们得到的示例:

不出所料,这完全是无稽之谈。那么我们该如何改进呢?就像处理字母一样,我们可以开始考虑的不仅仅是单个单词的概率,还有单词对或更长的 n 元语法的概率。以单词对为例,以下是 5 个例子,所有例子都以单词“cat”开头:

它看起来稍微“合理”了一些。我们可以想象,如果我们能够使用足够长的 n -gram,基本上就能“得到一个 ChatGPT”——也就是说,我们能得到一个可以生成文章长度的词序列,并且这些词序列具有“正确的文章整体概率”的程序。但问题在于:迄今为止,英语文本的数量远远不足以推断出这些概率。
网络爬虫 可能包含数千亿个单词;数字化书籍中可能又包含数千亿个单词。但即使是 4 万个常用词,可能的双词组合数量也已达 16 亿,而三词组合的数量更是高达 60 万亿。因此,我们根本无法从现有的文本中估算出所有这些组合的概率。而当我们面对 20 个单词的“文章片段”时,其可能性数量甚至超过了宇宙中的粒子数量,从某种意义上说,它们永远不可能全部被记录下来。
那么我们能做什么呢?核心思路是构建一个模型,让我们能够估算出各种序列出现的概率——即使我们从未在所研究的文本语料库中明确地见过这些序列。而 ChatGPT 的核心正是所谓的“大型语言模型”(LLM),它的构建目的就是为了能够很好地估算这些概率。
什么是模型?
假设你想知道(就像 伽利略在 16 世纪末所做的那样 )从比萨斜塔每一层扔下的炮弹需要多长时间才能落地。你可以逐一测量,然后把结果列成表格。或者,你可以做理论科学的精髓所在:建立一个模型,用某种方法计算出答案,而不是仅仅测量和记住每个案例的结果。
假设我们有一些(理想化的)数据,记录了炮弹从不同楼层下落所需的时间:

我们如何计算从没有明确数据的楼层坠落需要多长时间?在这个例子中,我们可以利用已知的物理定律来计算。但假设我们只有坠落数据,却不知道其背后的规律,那么我们或许可以进行一些数学上的猜测,比如假设可以用直线作为模型:

我们可以选择不同的直线,但这条直线平均而言最接近我们已知的数据。根据这条直线,我们可以估算出从任何楼层坠落所需的时间。
我们怎么知道这里应该用直线拟合呢?某种程度上,我们并不知道。只是因为直线在数学上比较简单,而且我们已经习惯了这样一个事实:我们测量的很多数据都能用简单的数学公式很好地拟合。我们也可以尝试更复杂的数学公式——比如 a + b x + c x 2 ——在这种情况下,直线拟合的效果会更好:

不过,事情可能会变得非常糟糕。比如,这是我们用 a + b / x + c sin( x ) 能做到的最好结果 :

值得注意的是,根本不存在“无模型模型”。你使用的任何模型都有其特定的底层结构——然后还有一组可以调整的“旋钮”(即可以设置的参数)来拟合你的数据。以 ChatGPT 为例,它使用了大量的此类“旋钮”——实际上,多达 1750 亿个。
但令人惊讶的是,ChatGPT 的底层结构——“仅仅”有这么多参数——就足以创建一个能够“足够好”地计算下一个词概率的模型,从而为我们提供合理的文章长度的文本片段。
类人任务模型
我们上面举的例子是为数值数据建立模型,这些数据本质上来源于简单的物理学——几个世纪以来我们都知道“简单的数学原理适用于此”。但对于 ChatGPT,我们必须为人类语言文本建立模型,这种文本是由人脑产生的。而对于这类文本,我们(至少目前)还没有类似“简单的数学原理”的东西。那么,它的模型会是什么样的呢?
在讨论语言之前,我们先来谈谈另一项类似人类的任务:图像识别。举个简单的例子,我们来看数字图像(没错,这是一个 经典的机器学习例子 ):

我们可以做的一件事是,为每个数字获取一些样本图像:

为了确定输入图像是否对应某个特定数字,我们可以直接将其与已有的样本进行逐像素比较。但作为人类,我们似乎做得更好——因为我们仍然能够识别数字,即使是手写的数字,或者经过各种修改和扭曲的数字:

当我们为上面的数值数据建立模型时,我们能够给定一个数值 x ,并计算出特定 a 和 b 下的 a + bx 。那么,如果我们把每个像素的灰度值看作一个变量 x,是否存在一个关于所有这些变量的函数,其值能够告诉我们图像是第几位数字呢?事实证明,这样的函数是可以构造的。但不出所料,它并不简单。一个典型的例子可能涉及大约五十万次数学运算。
但最终结果是,如果我们把图像的像素值集合输入到这个函数中,它就会输出一个数字,指示图像对应的是哪个数字。稍后我们会讨论如何构建这样的函数,以及神经网络的概念。但现在,我们先把这个函数看作一个黑盒,输入图像(例如手写数字,以像素值数组的形式),然后输出这些图像对应的数字:

但这里究竟发生了什么?假设我们逐渐模糊一个数字。一开始,我们的函数还能“识别”它,比如识别为“2”。但很快它就“丢失”了识别结果,开始给出“错误”的结果:

但我们为什么说这是“错误”的结果呢?在这个例子中,我们知道所有图像都是通过模糊数字“2”得到的。但如果我们的目标是建立一个模拟人类图像识别能力的模型,那么真正的问题是:如果一个人在不知道图像来源的情况下,面对这样一张模糊图像,他会作何反应?
如果我们的函数得到的结果通常与人类的判断一致,那么我们就拥有了一个“好的模型”。而一个重要的科学事实是,对于像这样的图像识别任务,我们现在基本上知道如何构建能够做到这一点的函数。
我们能用数学方法证明它们有效吗?答案是否定的。因为要做到这一点,我们需要一套关于人类行为的数学理论。比如,取“2”的图像,改变几个像素。我们或许会认为,即使只有几个像素“错位”,我们仍然应该认为图像是“2”。但这种判断的适用范围究竟有多大呢?这取决于 人类的视觉感知 。当然,对于蜜蜂或章鱼来说,答案无疑会不同——而 对于假想中的外星人来说,答案则可能完全不同 。
神经网络
那么,我们用于 图像识别 等任务的典型模型究竟是如何工作的呢?目前最流行、最成功的方法是使用 神经网络 。神经网络发明 于 20 世纪 40 年代 ,其雏形与今天的应用非常接近,可以将其视为对 大脑工作 方式的一种简单理想化模拟。
人脑中大约有1000亿个神经元(神经细胞),每个神经元每秒最多可以产生上千次电脉冲。这些神经元连接成一张复杂的网络,每个神经元都有树状分支,可以将电信号传递给成千上万个其他神经元。粗略地说,某个神经元在某一时刻是否产生电脉冲,取决于它从其他神经元接收到的脉冲——不同的连接对脉冲的贡献“权重”也不同。
当我们“看到图像”时,图像中的光子照射到我们眼睛后部的感光细胞上,会在神经细胞中产生电信号。这些神经细胞与其他神经细胞相连,最终信号会经过一系列神经元层级。正是在这个过程中,我们“识别”了图像,最终“形成”了“我看到了数字2”的想法(或许最后还会做出一些反应,比如大声说出“二”这个词)。
上一节中的“黑盒”函数是这种神经网络的“数学化”版本。它恰好有 11 层(尽管只有 4 层“核心层”):

这个神经网络并没有什么特别“理论推导”之处;它只是 1998 年作为一项工程技术构建出来 ,并被证明行之有效而已。(当然,这和我们描述大脑是通过生物进化过程产生的并无太大区别。)
好的,但是像这样的神经网络是如何“识别事物”的呢?关键在于 吸引子的概念 。想象一下,我们有一些手写的数字 1 和 2 的图像:

我们希望所有的数字 1 都“被吸引到一个地方”,所有的数字 2 都“被吸引到另一个地方”。或者换句话说,如果一个图像“ 更接近于 1 ”而不是 2,我们希望它最终出现在“1 的位置”,反之亦然。
举个简单的例子,假设我们在平面上有一些位置,用点表示(在现实生活中,这些点可能是咖啡店的位置)。那么我们可以想象,从平面上的任意一点出发,我们总是希望到达距离最近的点(即,我们总是会去最近的咖啡店)。我们可以通过将平面划分为由理想化的“分水岭”分隔的区域(“吸引盆地”)来表示这一点:

我们可以将其理解为实现一种“识别任务”,其中我们并非要识别给定图像“最像”哪个数字,而是直接观察给定点与哪个点最接近。(我们在此展示的“沃罗诺伊图”设置将点分离在二维欧几里得空间中;数字识别任务可以理解为在由每幅图像中所有像素的灰度值构成的784维空间中进行非常类似的操作。)
那么,我们如何让神经网络“执行识别任务”呢?让我们考虑这个非常简单的例子:

我们的目标是接收一个对应于位置 { x, y } 的“输入”,然后将其“识别”为距离它最近的三个点中的哪一个。或者换句话说,我们希望神经网络计算出一个关于 { x, y } 的函数,例如:

那么我们如何用神经网络来实现这一点呢?本质上,神经网络是由一系列理想化的“神经元”(通常排列成层)连接而成的集合,一个简单的例子是:

每个“神经元”实际上都被用来评估一个简单的数值函数。要“使用”这个网络,我们只需在顶部输入数字(例如坐标 x 和 y ),然后让每一层的神经元“评估它们的函数”,并将结果向前传递到网络中——最终在底部产生最终结果:

在传统的(受生物启发的)神经网络结构中,每个神经元实际上都与前一层神经元存在一组特定的“输入连接”,每个连接都被赋予一个特定的“权重”(可以是正数或负数)。给定神经元的值由以下方式确定:将“前一层神经元”的值乘以其对应的权重,然后将这些乘积相加,再加上一个常数,最后应用一个“阈值”(或“激活”)函数。用数学术语来说,如果一个神经元的输入为 x = { x 1, x 2 …} ,那么我们计算 f [ w. x + b ],其中权重 w 和常数 b 通常针对网络中的每个神经元选择不同的值;而函数 f 通常保持不变。
计算 w · x + b 只是简单的矩阵乘法和加法运算。“激活函数” f 引入了非线性(并最终导致了非平凡的行为)。通常会使用各种激活函数;这里我们只使用 Ramp (或 ReLU):

对于我们希望神经网络执行的每个任务(或者等价地,对于我们希望它评估的每个总体函数),我们都会有不同的权重选择。(而且——正如我们稍后将讨论的——这些权重通常是通过使用机器学习,从我们想要的输出示例中“训练”神经网络来确定的。)
归根结底,每个神经网络都对应着某个整体的数学函数——尽管写出来可能很复杂。以上面的例子为例,它可以是:

ChatGPT 的神经网络也对应于这样一个数学函数——但实际上有数十亿个项。
但我们还是回到单个神经元吧。以下是一些示例,展示了具有两个输入(分别代表坐标 x 和 y )的神经元,在不同的权重和常数选择下(激活函数为 Ramp )可以计算出的函数:

那么,上面提到的那个更大的网络呢?嗯,它计算的是这样的:

虽然还不完全“正确”,但它与我们上面展示的“最近点”函数非常接近。
让我们看看其他一些神经网络的情况。正如我们稍后将解释的,在每种情况下,我们都使用机器学习来找到最佳权重组合。然后,我们在这里展示使用这些权重的神经网络的计算结果:

通常来说,规模更大的神经网络在逼近我们想要的函数方面表现更好。而且,在“每个吸引子盆地的中心区域”,我们通常能得到想要的确切答案。但 在边界处 ——神经网络“难以做出决定”的地方——情况就可能变得复杂。
对于这种简单的数学式“识别任务”,“正确答案”显而易见。但在识别手写数字的问题上,情况就没那么简单了。如果有人把“2”写得像“7”一样糟糕,该怎么办?尽管如此,我们仍然可以探究神经网络是如何区分数字的——以下信息或许能提供一些线索:

我们能用“数学”的方式解释神经网络是如何进行区分的吗?其实不能。我们只能说“神经网络本身就是这样工作的”。但结果证明,这通常与我们人类所做的区分相当吻合。
我们来看一个更复杂的例子。假设我们有一些猫和狗的图片,并且我们有一个 经过训练的神经网络来区分它们 。以下是它在一些例子中的表现:

现在,什么是“正确答案”就更难说了。比如说,一只穿着猫咪服装的狗呢?等等。无论输入什么,神经网络都会生成一个答案,而且其方式与人类的思维方式相当一致。正如我前面所说,这并非我们可以“从第一性原理推导出来”的事实。这只是在某些领域,至少在某些经验领域中被证实为真。但这正是神经网络有用之处的关键所在:它们在某种程度上捕捉到了“类人”的做事方式。
给自己看一张猫的图片,然后问自己“为什么这是一只猫?”。你可能会说“嗯,我看到了它尖尖的耳朵等等。”但要解释你是如何识别出这是一只猫的,并不容易。你的大脑不知怎么就识别出来了。但对于大脑来说,(至少目前)我们无法“进入”它的内部,了解它是如何识别出来的。那么对于(人工)神经网络来说呢?当你给它看一张猫的图片时,很容易看出每个“神经元”在做什么。但即使是获得一个基本的可视化结果,通常也非常困难。
在我们之前用于解决“最近点”问题的最终网络中,有17个神经元。用于识别手写数字的网络有2190个神经元。而我们用于识别猫狗的网络则有60650个神经元。通常来说,要想象一个60650维的空间是相当困难的。但由于这是一个用于处理图像的网络,它的许多神经元层都像它所处理的像素数组一样,被组织成数组。
如果我们以一张典型的猫的图片为例。

然后,我们可以通过一系列衍生图像来表示第一层神经元的状态——其中许多图像我们可以很容易地解释为“没有背景的猫”或“猫的轮廓”之类的东西:

到了第十层,就很难理解发生了什么:

但总的来说,我们可以说神经网络“提取出某些特征”(尖耳朵可能就是其中之一),并利用这些特征来判断图像的内容。但是,这些特征是我们知道名称的吗——比如“尖耳朵”?大多数情况下不是。
我们的大脑是否使用类似的特征?我们大多不得而知。但值得注意的是,像我们这里展示的这种神经网络的前几层似乎会提取出图像中的某些特征(例如物体的边缘),这些特征与我们已知大脑第一层视觉处理所提取的特征相似。
但假设我们想要一个关于神经网络“猫识别理论”的模型。我们可以说:“看,这个特定的网络可以做到这一点”——这立刻让我们对问题的“难度”有了一定的了解(例如,可能需要多少神经元或层)。但至少目前,我们还没有办法“用叙述的方式描述”网络的运行过程。也许是因为它在计算上确实是不可简化的,除了显式地追踪每一步之外,没有其他通用的方法来了解它的运行机制。又或许仅仅是因为我们还没有“弄懂其中的科学原理”,还没有找到能够让我们概括整个过程的“自然规律”。
当我们讨论如何使用 ChatGPT 生成语言时,也会遇到类似的问题。同样,目前还不清楚是否有办法“概括它正在做什么”。但语言的丰富性和细节性(以及我们对语言的经验)或许能让我们比使用图像走得更远。
机器学习与神经网络的训练
我们目前讨论的都是“已经知道”如何执行特定任务的神经网络。但神经网络之所以如此有用(想必在人脑中也是如此),不仅在于它们原则上可以执行各种任务,而且还可以通过“从示例中逐步训练”来掌握这些任务。
当我们制作一个用于区分猫和狗的神经网络时,我们实际上不必编写一个(比如说)明确查找胡须的程序;相反,我们只需展示大量猫和狗的例子,然后让网络从中“学习”如何区分它们。
关键在于,训练好的网络能够从它所看到的特定示例中进行“泛化”。正如我们上面所看到的,这不仅仅是网络识别出它所看到的猫图像的特定像素模式;而是神经网络能够根据我们认为的某种“猫的特征”来区分图像。
那么神经网络训练究竟是如何进行的呢?本质上,我们一直在努力寻找合适的权重,使神经网络能够成功地复现我们提供的示例。然后,我们依靠神经网络以“合理”的方式在这些示例之间进行“插值”(或“泛化”)。
让我们来看一个比上面最近点问题更简单的问题。我们尝试让神经网络学习这个函数:

完成这项任务,我们需要一个只有一个输入和一个输出的网络,例如:

但是我们应该使用哪些权重等等呢?神经网络会使用每一组可能的权重来计算某个函数。例如,以下是它使用几组随机选择的权重所执行的操作:

是的,我们可以清楚地看到,在这些情况下,它都无法接近我们想要的函数。那么,我们如何找到能够重现该函数的权重呢?
基本思路是提供大量的“输入→输出”示例进行“学习”,然后尝试找到能够重现这些示例的权重。以下是逐步增加示例数量后得到的结果:

在这个“训练”过程的每个阶段,网络中的权重都会逐步调整——最终我们会得到一个能够成功复现我们想要的功能的网络。那么,我们该如何调整权重呢?基本思路是在每个阶段都观察我们距离目标函数“还有多远”,然后更新权重,使之更接近目标函数。
为了找出“我们距离目标有多远”,我们计算通常所说的“损失函数”(有时也称为“成本函数”)。这里我们使用一个简单的(L2)损失函数,它就是我们得到的值与真实值之差的平方和。我们可以看到,随着训练过程的进行,损失函数逐渐减小(遵循一定的“学习曲线”,不同任务的学习曲线也不同)——直到网络(至少在很好的近似下)成功地重现了我们想要的函数:

好的,最后一个需要解释的关键点是如何调整权重来降低损失函数。正如我们所说,损失函数衡量的是已得到值与真实值之间的“距离”。但是,这些“已得到值”是由神经网络的当前版本及其权重在每个阶段决定的。现在假设权重是变量——比如 w。我们想要找到如何调整这些变量的值,以最小化取决于它们的损失。
例如,假设(为了对实际应用中的典型神经网络进行极大的简化)我们只有两个权重 w 1 和 w 2 。那么,损失函数作为 w 1 和 w 2 的函数,可能如下所示:

数值分析提供了多种方法来寻找此类情况下的最小值。但一种典型的方法是,从我们之前得到的 w 1 、 w 2 出发,逐步沿着最陡下降路径前进:

就像水从山上流下来一样,唯一可以确定的是,这个过程最终会到达地表的某个局部最小值(“山间湖泊”);它很可能不会到达最终的全球最小值。
在“权重景观”上找到最陡下降路径并非易事。但微积分可以帮我们解决这个问题。正如我们前面提到的,我们可以把神经网络看作是在计算一个数学函数——这个函数取决于它的输入和权重。现在考虑对这些权重求导。事实证明,微积分的链式法则实际上可以让我们“解构”神经网络中每一层执行的操作。结果是,我们至少可以在某种局部近似下“逆向”神经网络的运算,并逐步找到使输出损失最小化的权重。
上图展示了在只有两个权重的极端简单情况下,我们可能需要进行的最小化操作。但事实证明,即使权重数量远超于此(ChatGPT 使用了 1750 亿个权重),仍然可以进行最小化,至少可以达到一定的近似程度。实际上,2011 年前后“深度学习”领域的一项重大突破,正是源于这样一种发现:在权重数量较多的情况下,进行(至少是近似地)最小化操作在某种程度上比权重数量较少的情况更容易。
换句话说——这有点违反直觉——用神经网络解决更复杂的问题可能比解决简单的问题更容易。其大致原因似乎是,当拥有大量“权重变量”时,就形成了一个高维空间,其中包含“许多不同的方向”,这些方向可以引导我们找到最小值;而当变量较少时,就更容易陷入局部最小值(“山湖”),而从中“找不到出路”。
值得指出的是,在典型情况下,许多不同的权重组合都能得到性能几乎相同的神经网络。而且,在实际的神经网络训练中,通常会做出许多随机选择,从而产生“不同但等效的解决方案”,例如:

但每一种这样的“不同解”至少都会有细微的差别。如果我们要求对训练样本区域之外的区域进行“外推”,我们可能会得到截然不同的结果:

但这些方法中哪一个才是“正确”的呢?其实很难说。它们都“与观察到的数据相符”。但它们都对应着不同的“内在”思维方式,即跳出固有框架思考如何做事。而且,对我们人类来说,有些方法可能比其他方法“更合理”。
神经网络训练的实践与理论
尤其是在过去十年里,神经网络训练技术取得了长足的进步。没错,它本质上是一门艺术。有时——尤其是在回顾过去的时候——人们或许能从中窥见一丝“科学解释”的端倪。但大多数情况下,都是通过反复试验发现的,不断积累各种想法和技巧,最终构建起一套关于如何运用神经网络的丰富经验和理论体系。
其中包含几个关键部分。首先,要考虑针对特定任务应该使用哪种神经网络架构。其次,如何获取训练神经网络所需的数据也是一个至关重要的问题。而且,现在越来越少地需要从零开始训练神经网络:新的神经网络可以直接整合另一个已训练好的神经网络,或者至少可以利用该神经网络生成更多的训练样本。
人们或许会认为,每一种特定的任务都需要不同的神经网络架构。但研究发现,即使是看似截然不同的任务,同一种架构也常常有效。这在某种程度上让人联想到 通用计算的概念 (以及我的 计算等价性原理 ),但正如我稍后将要讨论的,我认为这更多地反映了这样一个事实:我们通常试图让神经网络完成的任务是“类人类”的任务——而神经网络能够捕捉到相当普遍的“类人类过程”。
在神经网络发展的早期,人们倾向于“让神经网络尽可能少地工作”。例如,在 将语音转换为文本 时,人们认为应该首先分析语音的音频,将其分解成音素等等。但后来发现,至少对于“类人任务”而言,通常最好是直接训练神经网络处理“端到端问题”,让它自行“发现”必要的中间特征、编码等等。
还有一种想法是,应该在神经网络中引入复杂的独立组件,使其能够“明确地实现特定的算法思想”。但事实证明,这大多得不偿失;相反,最好还是使用非常简单的组件,让它们“自我组织”(尽管通常是以我们无法理解的方式),从而(大概)实现与这些算法思想等效的效果。
这并非意味着神经网络不存在任何相关的“结构化思路”。例如,在图像处理的早期阶段,使用 具有局部连接的二维神经元阵列 似乎非常有用。而拥有专注于“回顾序列”的连接模式,在处理诸如人类语言之类的任务时也很有用——正如我们稍后将看到的,例如在 ChatGPT 中。
但神经网络的一个重要特点是——就像一般的计算机一样——它们最终处理的是数据。目前的神经网络——以及目前的神经网络训练方法 ——专门处理数字数组 。但在处理过程中,这些数组可以被完全重新排列和重塑。例如, 我们上面用于识别数字的网络 最初是一个二维的“图像状”数组,它迅速“扩展”成多个通道,然后 “缩小”成一个一维数组 ,最终包含代表不同可能输出数字的元素:

但是,好吧,如何才能知道完成特定任务需要多大的神经网络呢?这有点像一门艺术。在某种程度上,关键在于了解“任务的难度”。但对于类似人类的任务来说,这通常很难估计。没错,或许存在一种系统化的方法,可以让计算机非常“机械地”完成任务。但很难知道是否存在一些技巧或捷径,能够让人更轻松地以“类似人类的水平”完成任务。或许需要 枚举一个庞大的游戏树 才能“机械地”玩某个游戏;但或许存在一种更简单(“启发式”)的方法来实现“人类水平的玩法”。
当处理小型神经网络和简单任务时,有时会清楚地看到“无法从这里到达那里”。例如,以下是使用几个小型神经网络在上一节任务上似乎能够达到的最佳结果:

我们看到,如果网络规模太小,就无法重现我们想要的函数。但当网络规模超过一定限度后,就不会有问题——至少在训练时间足够长、样本足够多的情况下是如此。顺便一提,这些图也揭示了神经网络的一个基本原理:如果在网络中间设置一个“压缩层”,迫使所有数据都经过较少数量的中间神经元,那么通常可以使用规模较小的网络。(值得一提的是,“无中间层”——或者所谓的“ 感知器 ”——网络只能学习本质上的线性函数——但只要有一个中间层 ,原则上总是可以 任意精确地逼近任何函数,至少在神经元数量足够的情况下是这样,尽管为了便于训练,通常会进行某种形式的 正则化或归一化 。)
好的,假设我们已经确定了某种神经网络架构。现在的问题是如何获取训练数据。许多围绕神经网络(以及机器学习)的实际挑战都集中在获取或准备必要的训练数据上。在很多情况下(“监督学习”),我们需要明确的输入示例以及预期输出。例如,我们可能需要根据图像内容或其他属性对其进行标记。有时,我们可能需要手动进行标记——通常需要花费大量精力。但很多时候,我们可以利用已有的成果,或者将其用作某种代理。例如,我们可以使用网络上图像的替代文本(alt 标签)。或者,在其他领域,我们可以使用视频的字幕。又或者,对于语言翻译训练,我们可以使用不同语言版本的网页或其他文档。
要训练神经网络完成特定任务,需要多少数据?同样,这很难从根本上估算。当然,通过“迁移学习”,我们可以大幅减少数据需求,例如将其他网络中已经学习到的重要特征列表“迁移”到本网络中。但通常来说,神经网络需要“看到大量示例”才能训练得好。至少对于某些任务而言,示例可以高度重复,这是神经网络领域的一个重要知识点。事实上,将所有示例反复展示给神经网络是一种标准策略。在每一轮“训练”(或“训练周期”)中,神经网络的状态至少会略有不同,而“提醒”它某个特定示例有助于它“记住该示例”。(是的,这或许类似于重复在人类记忆中的作用。)
但通常情况下,仅仅反复展示同一个例子是不够的。还需要展示该例子的神经网络变体。神经网络领域的一个特点是,这些“数据增强”变体并不需要多么复杂才能发挥作用。只需使用基本的图像处理技术对图像进行一些简单的修改,就能使它们几乎“焕然一新”,适用于神经网络训练。同样地,当缺乏用于训练自动驾驶汽车的实际视频等素材时,也可以通过在类似电子游戏的模拟环境中运行程序来获取数据,而无需包含真实世界场景的所有细节。
ChatGPT 怎么样?它有一个很棒的特性,就是可以进行“无监督学习”,这使得获取训练样本变得更加容易。回想一下,ChatGPT 的基本任务是弄清楚如何接续给定的文本。因此,要获得“训练样本”,只需获取一段文本,遮盖住结尾部分,然后将此部分作为“训练输入”,而“输出”则是完整的、未遮盖的文本。我们稍后会详细讨论这一点,但关键在于——与学习图像内容不同——不需要“显式标注”;ChatGPT 实际上可以直接从给定的任何文本样本中学习。
好的,那么神经网络的实际学习过程是怎样的呢?归根结底,就是确定哪些权重能够最好地捕捉给定的训练样本。有很多细节选择和“超参数设置”(之所以这样称呼,是因为权重可以被视为“参数”)可以用来调整这个过程。 损失函数有不同的选择 (平方和、绝对值和等等)。损失最小化的方法也不同(每一步在权重空间中移动多远等等)。此外,还有一些问题,比如需要多大的样本“批次”才能获得每次损失估计值。当然,我们可以应用机器学习(例如,我们在 Wolfram 语言中所做的)来实现机器学习的自动化——并自动设置超参数之类的东西。
但最终,整个训练过程可以通过观察损失如何逐渐减少来描述(如 Wolfram Language 的这个小型训练进度监视器 所示):

通常情况下,损失值会先下降一段时间,然后趋于稳定在一个恒定值。如果这个值足够小,则可以认为训练成功;否则,这可能表明应该尝试改变网络架构。
能否预测“学习曲线”需要多长时间才能趋于平缓?就像许多其他事物一样, 神经网络的训练似乎存在近似幂律关系 ,具体取决于神经网络的规模和所用数据量。但总的来说,训练神经网络非常困难,需要大量的计算资源。实际上,绝大部分计算资源都消耗在对数字数组进行运算上,而这正是 GPU 的优势所在——因此,神经网络训练通常会受到 GPU 可用性的限制。
未来,是否会有更优的神经网络训练方法——或者说,是否会有更优的神经网络实现方式?我认为几乎肯定会。神经网络的基本理念是用大量简单(本质上相同)的组件构建一个灵活的“计算架构”,并且这个“架构”可以逐步修改,从而从示例中学习。在目前的神经网络中,我们本质上是将微积分的思想应用于实数,来进行这种逐步修改。但越来越明显的是,高精度数字并非关键;即使使用当前的方法,8 位或更低的精度也可能足够了。
对于 像元胞自动机这样基本上并行处理多个独立比特的计算系统来说 , 如何进行这种增量式修改 一直是个谜,但没有理由认为它不可能实现。事实上,就像“ 2012 年深度学习的突破 ”一样,这种增量式修改在更复杂的情况下可能比在简单情况下更容易实现。
神经网络——或许有点像大脑——被设计成拥有一个基本固定的神经元网络,唯一可调整的是神经元之间连接的强度(“权重”)。(或许在年轻的大脑中,还能生长出大量全新的连接。)虽然这种设计对生物学来说可能很方便,但它是否是实现我们所需功能的最佳途径,目前还远未可知。而某种类似于渐进式网络重写的方法(或许可以让我们联想到之前的 物理项目 )最终可能会更好。
但即便在现有神经网络的框架内,目前也存在一个关键的局限性:目前的神经网络训练本质上是顺序进行的,每一批样本的影响都会被反向传播以更新权重。事实上,即使考虑到 GPU,在当前的计算机硬件条件下,神经网络的大部分在训练过程中也处于“空闲”状态,每次只更新一部分。从某种意义上说,这是因为我们目前的计算机往往拥有独立于 CPU(或 GPU)的内存。但在大脑中,情况可能有所不同——每个“记忆单元”(即神经元)同时也是一个潜在的活跃计算单元。如果我们能够以这种方式构建未来的计算机硬件,或许就能更高效地进行训练。
“规模足够大的网络肯定无所不能!”
ChatGPT 之类的工具的功能似乎令人印象深刻,人们可能会认为,如果能够“不断改进”,训练越来越大的神经网络,最终就能“无所不能”。如果人们关注的是人类思维能够直接理解的事物,那么这种情况很有可能发生。但过去几百年的科学经验告诉我们,有些事物可以通过形式化的方法解决,但却无法被人类思维直接理解。
非平凡数学就是一个典型的例子。但更普遍的情况是计算。归根结底,问题在于 计算不可约性 现象。有些计算看似需要很多步骤,但实际上可以“简化”成相当直接的结果。然而,计算不可约性的发现表明,这种方法并非总是有效。相反,有些过程——可能类似于下面的例子——要弄清楚发生了什么,就必然需要追踪每一个计算步骤:

我们通常用大脑进行的活动,想必都是为了避免计算不可约性而特意选择的。用大脑进行数学运算需要付出特殊的努力。而且,实际上,仅凭大脑“思考”出任何复杂程序的运行步骤几乎是不可能的。
当然,我们有计算机来解决这个问题。有了计算机,我们就能轻松完成耗时且计算量巨大的任务。关键在于,这类任务通常没有捷径可走。
是的,我们可以记住很多特定计算系统中发生的具体例子。或许我们还能发现一些(“计算可约化”)的模式,从而进行一些概括。但关键在于,计算不可约性意味着我们永远无法保证意外情况不会发生——只有通过显式地进行计算,才能知道在任何特定情况下实际发生了什么。
归根结底,可学习性和计算不可约性之间存在着根本性的矛盾。学习实际上涉及 利用规律性来压缩数据 。但计算不可约性意味着规律性的数量最终是有限的。
| 实际上,我们可以设想将一些小型计算设备——例如元胞自动机或图灵机——构建成可训练系统,例如神经网络。事实上,这些设备可以作为神经网络的良好“工具”——就像 [Wolfram | Alpha 可以作为 ChatGPT 的良好工具](https://writings.stephenwolfram.com/2023/01/wolframalpha-as-the-way-to-bring-computational-knowledge-superpowers-to-chatgpt/) 一样。但是,计算不可约性意味着我们不能期望“进入”这些设备内部并让它们进行学习。 |
换句话说,能力和可训练性之间存在着根本的权衡:你越希望一个系统“真正利用”其计算能力,它就越会表现出计算不可简化性,而可训练性就越低。反之,它越容易训练,就越难以进行复杂的计算。
(就目前的 ChatGPT 而言,情况实际上要极端得多,因为用于生成每个输出词元的神经网络是一个纯粹的“前馈”网络,没有循环,因此无法进行任何具有非平凡“控制流”的计算。)
当然,人们可能会质疑,进行不可约计算的能力究竟有多重要。事实上,在人类历史的大部分时间里,它并不特别重要。但我们现代的科技世界建立在工程技术之上,而工程技术至少运用了数学计算——而且越来越多地运用了更通用的计算。如果我们观察自然界,就会发现它 充满了不可约计算 ——我们正在逐步了解如何模拟这些计算,并将其应用于我们的技术发展中。
是的,神经网络当然可以注意到自然界中那些我们“无需辅助的人类思维”也能轻易注意到的规律。但如果我们想解决那些属于数学或计算科学范畴的问题,神经网络就无能为力了——除非它有效地“利用”一个“普通”的计算系统作为工具。
但这一切可能存在一些令人困惑的地方。过去,我们常常认为很多任务——包括写文章——对计算机来说“从根本上来说太难了”。而现在,当我们看到像 ChatGPT 这样的程序完成这些任务时,我们往往会突然觉得计算机的能力一定大幅提升了——尤其是在一些它们原本就能完成的任务上(比如逐步计算元胞自动机等计算系统的行为)。
但这并非正确的结论。计算上不可简化的过程仍然是计算上不可简化的,对计算机而言仍然极其困难——即便计算机能够轻易计算出它们的各个步骤。我们真正应该得出的结论是:那些我们人类能够完成,但我们认为计算机无法完成的任务——比如撰写文章——实际上在某种意义上比我们想象的要容易计算。
换句话说,神经网络之所以能够成功撰写文章,是因为撰写文章这个问题在计算上比我们想象的要“简单得多”。从某种意义上说,这使我们更接近于“拥有一个理论”,解释我们人类是如何完成诸如撰写文章之类的任务,或者说,是如何处理语言的。
如果你拥有足够庞大的神经网络,那么,是的,你或许能够做到人类可以轻松做到的一切。但你无法捕捉到自然界整体所能做到的——也无法捕捉到我们从自然界中汲取灵感而创造出的工具所能做到的。正是这些工具——无论是实用工具还是概念工具——的运用,使得我们在近几个世纪以来超越了“纯粹的、未经辅助的人类思维”所能触及的界限,并将物理和计算世界中更多的事物用于人类的用途。
嵌入的概念
神经网络——至少就目前的架构而言——本质上是基于数字的。因此,如果我们要用它们来处理文本之类的东西,就需要一种方法来 用数字表示文本 。当然,我们可以从给字典中的每个单词分配一个数字开始(就像 ChatGPT 那样)。但是,有一个重要的概念——例如 ChatGPT 的核心概念——超越了这一点。那就是“嵌入”的概念。我们可以把嵌入理解为一种尝试用数字数组来表示事物“本质”的方法——其特点是“邻近的事物”由邻近的数字表示。
例如,我们可以把词嵌入理解为尝试 将单词排列在一个“意义空间”中, 在这个空间里,意义相近的单词在嵌入中也彼此相邻。实际使用的词嵌入(例如 ChatGPT 中使用的词嵌入)通常涉及大量的数字列表。但如果我们将其投影到二维空间,就可以展示词嵌入是如何排列单词的:

没错,我们所看到的模型在捕捉典型的日常印象方面表现出色。但是,我们该如何构建这样的词嵌入呢?大致思路是分析大量文本(这里指的是来自网络的 50 亿个单词),然后观察不同词语出现的“环境”的相似程度。例如,“alligator”(短吻鳄)和“crocodile”(鳄鱼)在其他方面相似的句子中经常几乎可以互换出现,这意味着它们在词嵌入中会彼此靠近。但“turnip”(萝卜)和“eagle”(鹰)在其他方面相似的句子中则很少出现,因此它们在词嵌入中会相距甚远。
但是,如何用神经网络来实现这样的功能呢?我们先来谈谈图像的嵌入,而不是词语的嵌入。我们希望找到一种方法,用数字列表来描述图像,使得“我们认为相似的图像”被赋予相似的数字列表。
我们如何判断是否应该“将图像视为相似”呢?例如,如果我们的图像是手写数字,那么如果两张图像包含相同的数字,我们就可以“将两张图像视为相似”。之前我们讨论过一个训练用于识别手写数字的神经网络。我们可以把这个神经网络想象成这样:它的最终输出是将图像放入10个不同的“箱子”中,每个箱子对应一个数字。
但是,如果我们能在神经网络做出最终的“它是‘4’”的决定之前,就“拦截”到它内部的运行过程呢?我们或许可以预期,神经网络内部存在一些数字,这些数字能够表征图像的性质,例如“大部分像4,但也有一点像2”等等。我们的想法是,提取出这些数字,并将它们作为嵌入的元素。
所以,这个概念是这样的:我们不再直接尝试描述“哪张图像与哪张图像相邻”,而是考虑一个定义明确的任务(在本例中是数字识别),并为此获取明确的训练数据——然后利用神经网络在执行此任务时需要隐式地做出“邻近性判断”这一事实。因此,我们无需明确地讨论“图像的邻近性”,而只需讨论图像代表哪个数字这个具体问题,然后“交给神经网络”来隐式地确定这其中蕴含的“图像邻近性”信息。
那么,对于数字识别网络来说,具体来说它是如何工作的呢?我们可以把这个网络想象成由11个连续的层组成,我们可以用图示的方式概括如下(激活函数以单独的层表示):

一开始,我们将实际图像输入到第一层,这些图像由像素值的二维数组表示。最后,从最后一层,我们得到一个包含 10 个值的数组,我们可以将其理解为网络判断图像与数字 0 到 9 对应的“确定性”程度。
输入图像 ,最后一层神经元的值如下:

换句话说,此时神经网络“非常确定”这张图片是数字 4——而要真正得到输出“4”,我们只需要找出具有最大值的神经元的位置即可。
但如果我们再往前看一步呢?网络中的最后一个操作是所谓的 softmax ,它试图“强制确定性”。但在应用 softmax 之前,神经元的值是:

代表“4”的神经元仍然具有最高的数值。但其他神经元的值中也包含信息。我们可以预期,这组数字在某种意义上可以用来刻画图像的“本质”,从而提供我们可以用作嵌入的东西。例如,这里每个“4”都有略微不同的“特征”(或“特征嵌入”),都与“8”截然不同:

这里我们基本上只用了 10 个数字来描述图像。但通常情况下,使用更多的数字会更好。例如,在我们的数字识别网络中,我们可以通过调用前一层来获得一个包含 500 个数字的数组。这或许是一个适合用作“图像嵌入”的合理数组。
如果我们想要对“手写数字的图像空间”进行明确的可视化,我们需要“降低维度”,实际上是将我们得到的 500 维向量投影到例如 3D 空间中:

我们刚才讨论了如何基于图像相似性来创建图像特征(以及嵌入),这可以通过判断图像是否(根据我们的训练集)对应于同一个手写数字来实现。如果我们有一个训练集,能够识别每张图像属于5000种常见物体类型(猫、狗、椅子……)中的哪一种,那么我们就可以更普遍地对图像进行类似的操作。这样,我们就可以创建一个以常见物体类型为“锚点”的图像嵌入,然后根据神经网络的行为“围绕这些常见物体进行泛化”。关键在于,只要这种行为与我们人类感知和解释图像的方式相符,最终得到的嵌入就会“让我们感觉正确”,并且在实践中用于执行类似人类判断的任务。
好的,那么我们如何用同样的方法找到词嵌入呢?关键在于从一个容易训练的词相关任务入手。而标准的这类任务就是“词预测”。假设我们给定“___猫”。基于一个大型文本语料库(例如,网络文本内容),哪些不同的词可以“填入空白处”?或者,换个角度来说,给定“___黑色___”,哪些不同的“侧翼词”的概率又是多少?
我们如何为神经网络设置这个问题呢?最终,我们必须用数字来表示一切。一种方法是给英语中大约 5 万个常用词中的每一个都分配一个唯一的数字。例如,“the”可能是 914,“cat”(前面带空格)可能是 3542。(这些是 GPT-2 实际使用的数字。)所以对于“the ___ cat”这个问题,我们的输入可能是 {914, 3542}。输出应该是什么样的呢?它应该是一个包含大约 5 万个数字的列表,这些数字有效地给出了每个可能的“填充”词的概率。同样,为了找到嵌入向量,我们希望在神经网络“得出结论”之前“拦截”其“内部”——然后提取出现在那里的数字列表,我们可以将其视为“每个词的特征”。
好的,那么这些特征描述具体是什么样的呢?过去十年间,涌现出了一系列不同的系统( word2vec 、 GloVe 、 BERT 、 GPT ……),每个系统都基于不同的神经网络方法。但归根结底,它们都是将单词提取出来,并用成百上千个数字列表来描述它们。
这些原始的“嵌入向量”信息量非常有限。例如,以下是 GPT-2 为三个特定词语生成的原始嵌入向量:

如果我们测量这些向量之间的距离,就能找到词语之间的“邻近度”之类的信息。稍后我们会更详细地讨论这种嵌入的“认知”意义。但现在最重要的是,我们找到了一种将词语有效地转换为“神经网络友好型”数字集合的方法。
但实际上,我们不仅可以用数字集合来描述单词,还可以对单词序列,甚至是整段文本进行类似的处理。ChatGPT 就是这样处理的。它获取已有的文本,并生成一个嵌入向量来表示它。然后,它的目标是找到接下来可能出现的不同单词的概率。它将结果表示为一个数字列表,该列表包含了大约 5 万个可能单词中每个单词的概率。
(严格来说,ChatGPT 处理的不是单词, 而是“词元” ——一种方便的语言单位,可以是完整的单词,也可以是像“pre”、“ing”或“ized”这样的词组。使用词元可以让 ChatGPT 更轻松地处理罕见词、复合词和非英语单词,有时,无论好坏,它还能创造出新词。)
ChatGPT 内部
好了,我们终于可以讨论 ChatGPT 的内部构造了。没错,它本质上是一个庞大的神经网络——目前是拥有 1750 亿个权重的 GPT-3 网络版本。在很多方面,它与我们之前讨论过的其他神经网络非常相似。但它是专门为处理语言而设计的神经网络。它最显著的特点是使用了一个名为“Transformer”的神经网络架构。
在我们前面讨论的第一种神经网络中,每一层中的每个神经元基本上都与前一层中的每个神经元相连(至少具有一定的权重)。但是,如果处理的数据具有特定的、已知的结构,这种全连接网络(可能)就显得过于复杂了。因此,例如,在处理图像的早期阶段,通常会使用所谓的 卷积神经网络 (“卷积神经网络”),其中神经元有效地排列在一个类似于图像像素的网格上,并且只与网格上相邻的神经元相连。
Transformer 的理念是,对构成文本的词元序列进行类似处理。但与简单地在序列中定义一个固定的连接区域不同,Transformer 引入了“ 注意力 ”的概念——即对序列中的某些部分给予比其他部分更多的“关注”。或许有一天,我们可以直接创建一个通用的神经网络,并通过训练来实现所有定制化。但至少就目前而言,在实践中,“模块化”处理至关重要——正如 Transformer 所做的那样,或许也与我们的大脑运作方式类似。
那么,ChatGPT(或者更确切地说,是它所基于的 GPT-3 网络)究竟做了什么呢?回想一下,它的总体目标是根据训练数据(包括浏览来自网络等的数十亿页文本)以一种“合理”的方式继续输入文本。因此,在任何给定时刻,它都拥有一定长度的文本——其目标是为下一个要添加的词元找到合适的选择。
它分三个基本阶段运行。首先,它获取与当前文本对应的词元序列,并找到一个表示这些词元的嵌入向量(即一个数字数组)。然后,它以“标准神经网络的方式”对这个嵌入向量进行运算——数值在网络中逐层传递——生成一个新的嵌入向量(即一个新的数字数组)。接着,它取这个新数组的最后一部分,并从中生成一个包含约 50,000 个值的数组,这些值对应于下一个可能的词元的概率。(而且,恰好使用的词元数量与英语中常用词汇的数量大致相同,尽管其中只有大约 3,000 个词元是完整的单词,其余的都是词段。)
关键在于,这条流程的每个部分都由神经网络实现,其权重通过对网络进行端到端训练来确定。换句话说,除了整体架构之外,实际上没有任何其他部分是“显式设计”的;所有功能都是从训练数据中“学习”而来的。
然而,这种架构的设置方式包含大量细节——反映了各种经验和神经网络理论。而且——尽管这肯定会深入到细节层面——我认为讨论其中的一些细节是有益的,尤其有助于了解构建像 ChatGPT 这样的系统究竟需要哪些步骤。
首先是嵌入模块。以下是 GPT-2 的 Wolfram 语言表示示意图:

输入是一个 包含 n 个 词元的向量 (与上一节相同,用 1 到大约 50,000 的整数表示)。每个词元都通过 单层神经网络 转换为一个嵌入向量(GPT-2 的长度为 768,ChatGPT 的 GPT-3 的长度为 12,288)。同时,还有一个“辅助路径”,它接收词元 位置的(整数)序列 ,并根据这些整数创建另一个嵌入向量。最后,将词元值和词元位置对应的嵌入向量 相加 ,生成嵌入模块的最终嵌入向量序列。
为什么要把词值嵌入向量和词位置嵌入向量直接相加呢?我认为这其中并没有什么特别的科学原理。只是各种方法都尝试过了,而这种方法似乎行之有效。神经网络的理论基础之一就是——在某种程度上——只要设置“大致正确”,通常只需进行足够的训练就能逐步完善细节,而无需真正“从工程层面”理解神经网络最终是如何配置自身的。
以下是嵌入模块对字符串 hello hello hello hello hello hello hello hello hello bye bye bye bye bye bye bye bye bye bye bye 所做的操作:

页面下方显示了每个词元的嵌入向量元素,页面上方首先是一连串“ hello ”的嵌入向量,然后是一连串“ bye ”的嵌入向量。上面的第二个数组是位置嵌入向量——它看起来有些随机的结构正是“碰巧被学习到的”(在本例中是 GPT-2 学习到的)。
好的,嵌入模块之后就是 Transformer 的“主线”:一系列所谓的“注意力模块”(GPT-2 有 12 个,ChatGPT 的 GPT-3 有 96 个)。这套流程相当复杂——让人想起典型的难以理解的大型工程系统,或者,就此而言,也让人想起生物系统。不过,这里还是放一个 GPT-2 的“注意力模块”示意图:

每个这样的注意力模块内都包含一组“注意力头”(GPT-2 有 12 个,ChatGPT 的 GPT-3 有 96 个)——每个注意力头独立地处理嵌入向量中不同的值块。(是的,我们并不知道为什么要把嵌入向量拆分,也不知道它的各个部分“代表什么”;这只是“已被证明有效”的方法之一。)
好的,那么注意力头的作用是什么呢?简单来说,它们是一种“回顾”词元序列(即目前为止生成的文本)的方式,并将“过去的信息打包”成一种便于查找下一个词元的形式。 在上面的第一节中, 我们讨论了如何使用二元语法概率来根据单词的直接前导词来选择单词。Transformer 中的“注意力”机制允许“关注”更早出现的单词——从而有可能捕捉到动词指代句子中出现在其前面很多单词的名词的方式。
更详细地说,注意力头的作用是使用特定的权重重组与不同词元关联的嵌入向量中的数据块。例如,第一个注意力模块(在 GPT-2 中)中的 12 个注意力头对于上面的“ hello, bye ”字符串具有以下(“一直回溯到词元序列的开头”)“重组权重”模式:

经过注意力头处理后,得到的“重加权嵌入向量”(GPT-2 的长度为 768,ChatGPT 的 GPT-3 的长度为 12,288)会通过一个标准的 “全连接”神经网络层 。很难理解这一层的具体工作原理。但下图展示了它使用的 768×768 权重矩阵(此处以 GPT-2 为例):

Taking 64×64 moving averages, some (random-walk-ish) structure begins to emerge:
采用 64×64 移动平均线后,开始出现一些(类似随机游走的)结构:

是什么决定了这种结构?最终,它大概是某种人类语言特征的“神经网络编码”。但就目前而言,这些特征究竟是什么,我们仍然一无所知。实际上,我们正在“打开 ChatGPT(或者至少是 GPT-2)的大脑”,并发现,是的,它的内部结构非常复杂,我们并不理解它——尽管最终它能够生成可识别的人类语言。
好的,经过一个注意力模块后,我们得到了一个新的嵌入向量——然后这个向量会依次经过其他注意力模块(GPT-2 总共有 12 个;GPT-3 有 96 个)。每个注意力模块都有其特定的“注意力”和“全连接”权重模式。以下是 GPT-2 中第一个注意力头处理“hello, bye”输入时的注意力权重序列:

以下是全连接层的(移动平均)“矩阵”:

奇怪的是,尽管不同注意力模块中的这些“权重矩阵”看起来非常相似,但权重大小的分布可能略有不同(而且并不总是高斯分布):

那么,经过所有这些注意力模块之后,Transformer 的最终效果是什么呢?本质上,它是将原始词元序列的词嵌入集合转换为最终集合。ChatGPT 的具体工作方式是,选取该集合中的最后一个词嵌入,并对其进行“解码”,从而生成一个概率列表,用于预测下一个词元的出现概率。
以上就是 ChatGPT 的大致结构。它看起来可能很复杂(尤其因为它不可避免地包含许多略显随意性的“工程选择”),但实际上,其核心要素却非常简单。因为归根结底,我们处理的只是一个由“人工神经元”组成的神经网络,每个神经元都执行着一个简单的操作:接收一组数值输入,然后将它们与特定的权重组合起来。
ChatGPT 的原始输入是一个数字数组(目前为止词元的嵌入向量),当 ChatGPT 运行生成新词元时,这些数字会“传递”到神经网络的各个层,每个神经元“执行其功能”并将结果传递给下一层的神经元。整个过程没有循环或“返回”。所有信息都“向前”传递。
It’s a very different setup from a typical computational system—like a Turing machine —in which results are repeatedly “reprocessed” by the same computational elements. Here—at least in generating a given token of output—each computational element (i.e. neuron) is used only once.
这与典型的计算系统(例如图灵 机 )的设置截然不同——在典型的计算系统中,结果会被相同的计算单元反复“重新处理”。而在这里,至少在生成给定的输出样本时,每个计算单元(即神经元)都只使用一次。
但从某种意义上说,即使在 ChatGPT 中,仍然存在一个会重用计算元素的“外层循环”。因为当 ChatGPT 生成一个新词元时,它总是会“读取”(即作为输入)之前的所有词元序列,包括 ChatGPT 自身之前“写入”的词元。我们可以将这种设置理解为 ChatGPT 确实包含一个“反馈循环”——至少在其最外层——尽管在这个循环中,每一次迭代都会以词元的形式明确地出现在它生成的文本中。
但让我们回到 ChatGPT 的核心:用于生成每个词元的神经网络。从某种程度上来说,它非常简单:就是一系列相同的神经元集合。网络的某些部分由“ 全连接 ”的神经元层构成,其中每一层上的每个神经元都(以一定的权重)与前一层上的每个神经元相连。但 ChatGPT 的 Transformer 架构使其包含结构更复杂的部分,其中只有不同层上的特定神经元相连。(当然,也可以说“所有神经元都相连”——只是有些神经元的权重为零。)
此外,ChatGPT 神经网络的某些方面并非通常意义上由“同质”层构成。例如——正如上面的图示所示——在注意力模块内部,存在着对输入数据进行“多次复制”的情况,每个副本都会经过不同的“处理路径”,可能涉及不同数量的层,最终才进行重新组合。虽然这种描述方式便于理解,但至少在理论上,我们始终可以将其理解为“密集填充”层,只是将某些权重设为零。
如果观察 ChatGPT 的最长路径,会发现它大约包含 400 层(核心层)——从某种程度上来说,这个数字并不算大。但它却拥有数百万个神经元,总共有 1750 亿个连接,因此也对应着 1750 亿个权重。需要注意的是,ChatGPT 每次生成一个新词元时,都必须进行一次涉及所有这些权重的计算。在实现上,这些计算可以按层进行组织,形成高度并行的数组操作,从而方便地在 GPU 上完成。但即便如此,对于生成的每个词元,仍然需要进行 1750 亿次计算(最终可能还要更多一些)——所以,用 ChatGPT 生成一段长文本需要一些时间也就不足为奇了。
但最终,最令人惊奇的是,所有这些操作——尽管它们各自都很简单——竟然能够协同工作,出色地生成出“类人”文本。必须再次强调的是(至少就我们目前所知),并没有任何“终极理论理由”可以解释为什么这种方法会奏效。事实上,正如我们将要讨论的,我认为我们应该将其视为一项——或许令人惊讶的——科学发现:在像 ChatGPT 这样的神经网络中,竟然能够捕捉到人类大脑在语言生成方面所取得的成就的本质。
ChatGPT 的培训
好了,我们已经概述了 ChatGPT 的工作原理。但它是如何设置的呢?它神经网络中那 1750 亿个权重又是如何确定的呢?基本上,这些权重是基于海量文本语料库(包括网络、书籍等)进行大规模训练的结果,这些语料库都是由人类撰写的。正如我们所说,即使有了如此庞大的训练数据,神经网络能否成功生成“类人”文本也并非显而易见。而且,要实现这一点,似乎还需要一些精细的工程设计。但 ChatGPT 最大的惊喜——也是最大的发现——在于它证明了这一切是可能的。实际上,一个“仅仅”拥有 1750 亿个权重的神经网络就能构建出一个“相当不错的”人类文本模型。
在现代社会,人类撰写的大量文本以数字形式存在于网络上。公共网络上至少有数十亿个由人类撰写的页面,总计可能包含一万亿个单词。如果将非公开网页也计算在内,这个数字可能至少是公共网页的 100 倍。迄今为止,已有超过 500 万本书籍被数字化(在已出版的约 1 亿本书籍中),这又增加了约 1000 亿个单词。这还不包括视频等内容中语音提取的文本。(就我个人而言, 我一生发表的作品总数 略低于 300 万字,过去 30 年里我写了 大约 1500 万字的电子邮件,总共打字的字数可能达到了 5000 万字——而仅仅在过去几年里,我在 直播 中就说了超过 1000 万字。是的,我会用所有这些数据训练一个机器人。)
好的,有了这些数据,如何用它们来训练神经网络呢?基本过程与我们在上面简单示例中讨论的非常相似。你输入一批样本,然后调整网络中的权重,以最小化网络在这些样本上产生的误差(“损失”)。从误差进行“反向传播”的主要成本在于,每次进行反向传播时,网络中的每个权重通常都会发生至少微小的变化,而需要处理的权重数量非常庞大。(实际的“反向计算”通常只比正向计算难一个很小的常数因子。)
借助现代 GPU 硬件,并行计算数千个样本批次的结果非常简单。但是,当需要实际更新神经网络中的权重时,目前的方法基本上需要逐批进行。(没错,这或许正是大脑——凭借其计算和记忆能力——目前至少在架构上具有优势的地方。)
即使是在我们之前讨论过的看似简单的数值函数学习案例中,我们也发现通常需要数百万个样本才能成功训练一个网络,至少从零开始训练是如此。那么,这意味着我们需要多少样本才能训练一个“类人语言”模型呢?似乎没有任何根本性的“理论”方法可以知道答案。但实际上,ChatGPT 已经成功地使用数千亿个单词的文本进行了训练。
有些文本被反复输入,有些则只输入了一次。但不知何故,它从看到的文本中“获取了所需信息”。然而,鉴于需要学习的文本量如此庞大,它需要多大的神经网络才能“学好”呢?我们目前还没有一个基本的理论方法来回答这个问题。最终——正如我们将在下文进一步讨论的那样——人类语言以及人类通常用语言表达的内容,想必都包含着一定的“算法总量”。但下一个问题是,神经网络在实现基于这种算法总量的模型时,效率究竟如何。我们对此仍然一无所知——尽管 ChatGPT 的成功表明它的效率相当不错。
最后我们可以注意到,ChatGPT 使用了数千亿个权重来实现其功能——其数量与它所接收的训练数据的单词(或词元)总数相当。在某种程度上,这或许令人惊讶(尽管在 ChatGPT 的小型类似模型中也观察到了这种现象),即“网络规模”与“训练数据规模”如此接近,而这种规模似乎运行良好。毕竟,ChatGPT 内部并非“直接存储”了来自网络、书籍等的所有文本。因为 ChatGPT 内部实际存储的是一堆数字——精度略低于 10 位——这些数字是对所有文本聚合结构的某种分布式编码。
换句话说,我们可以探究人类语言的“有效信息含量”是什么,以及人们通常用它表达什么。这里存在着语言示例的原始语料库。然后是 ChatGPT 神经网络中的表示。这种表示很可能远非“算法最小”表示(我们将在下文讨论)。但它是神经网络可以轻松使用的表示。而且,在这种表示中,训练数据的“压缩”似乎相当少;平均而言,似乎只需要略少于一个神经网络权重就能承载训练数据中一个词的“信息含量”。
当我们运行 ChatGPT 生成文本时,基本上每个权重都需要使用一次。因此,如果有 n 个 权重,我们就需要执行大约 n 个 计算步骤——尽管在实践中,其中许多步骤通常可以在 GPU 上并行完成。但是,如果我们需要大约 n 个 单词的训练数据来设置这些权重,那么根据我们上面的讨论,我们可以得出结论,我们需要大约 n 个计算步骤来完成网络的训练——这就是为什么使用当前方法,最终需要花费数十亿美元进行训练的原因。
超越基础训练
训练 ChatGPT 的大部分精力都花在向它“展示”来自网络、书籍等的大量现有文本上。但事实证明,还有另一个——显然相当重要的——部分。
ChatGPT 内部的神经网络一旦完成对原始文本语料库的“原始训练”,便会开始生成自己的文本,并根据提示等条件进行后续生成。虽然生成的文本看起来通常还算合理,但尤其对于较长的文本,它们往往会“跑题”,而且跑题的方式往往不太像人类的表达方式。这种跑题很难通过传统的文本统计方法轻易发现,但真正的读者却能轻易察觉。
ChatGPT 构建的关键理念 在于,在“被动阅读”网页等内容之后,增加一个步骤:让真人用户主动与 ChatGPT 互动,观察其输出,并就“如何成为一个优秀的聊天机器人”提供反馈。但神经网络如何利用这些反馈呢?第一步是让用户对神经网络的输出结果进行评分。然后,构建另一个神经网络模型来预测这些评分。现在,这个预测模型可以像损失函数一样运行在原始网络之上,从而利用用户反馈对网络进行“调整”。实践证明,这种方法对系统生成“类人”输出的成功率有着显著的影响。
总的来说,有趣的是,对“初始训练”后的网络似乎只需要很少的“调整”就能使其朝着特定方向有效运行。人们可能会认为,要让网络表现得像“学到了新东西”,就必须运行训练算法,调整权重等等。
但事实并非如此。实际上,似乎只需要在提示信息中告诉 ChatGPT 一次,它就能在生成文本时成功运用这些信息。我认为,这种方法的有效性本身就是理解 ChatGPT “真正”在做什么,以及它与人类语言和思维结构之间关系的重要线索。
这其中确实有几分人性:至少在经过所有预训练之后,你只需告诉它一次,它就能“记住”——至少“足够长的时间”来生成一段文本。那么,这种情况究竟是怎么回事呢?或许是“你告诉它的所有内容都已经存在于某个地方”——你只是引导它找到正确的位置。但这似乎不太合理。更有可能的是,虽然元素确实已经存在,但具体细节是由某种“元素之间的轨迹”定义的,而当你告诉它某些内容时,你实际上是在引入这种轨迹。
的确,就像人类一样,如果你告诉它一些怪异且出乎意料、完全不符合它已知框架的事情,它似乎无法成功地“整合”这些信息。只有当这些信息以一种相当简单的方式依附于它已有的框架时,它才能“整合”这些信息。
值得再次指出的是,神经网络的“学习能力”必然存在“算法极限”。如果告诉它一些“浅层”规则,例如“这个对应那个”等等,神经网络很可能能够很好地表示和复现这些规则——事实上,它从语言中“已有的知识”会立即为它提供一个可遵循的模式。但是,如果试图给它提供一些涉及许多计算上可能无法简化的步骤的“深度”计算规则,它就无法正常工作了。(记住,在每一步中,它始终只是在网络中“向前传递数据”,除了生成新的词元之外,它永远不会循环。)
| 当然,神经网络可以学习特定“不可约”计算的答案。但是,一旦存在组合数数量级的可能性,这种“查表式”的方法就行不通了。因此,没错,就像人类一样,神经网络也该“伸出援手”,使用真正的计算工具了。(而且, [Wolfram | Alpha](https://www.wolframalpha.com/) 和 Wolfram Language 非常合适 ,因为它们的设计初衷就是为了“谈论现实世界”,就像语言模型神经网络一样。) |
ChatGPT 真正发挥作用的原理是什么?
人类语言——以及产生语言的思维过程——似乎一直代表着复杂性的巅峰。的确,人类大脑——仅仅拥有大约 1000 亿个神经元(以及可能 100 万亿个连接)——竟然能够产生如此丰富的语言,这着实令人惊叹。人们或许会认为,大脑的奥秘远不止于神经元网络,例如某种尚未被发现的物理学层面。但现在,有了 ChatGPT,我们获得了一项重要的新信息:我们知道,一个纯粹的、人工神经网络,其连接数与大脑的神经元数量大致相当,就能出色地生成人类语言。
没错,这仍然是一个庞大而复杂的系统——其神经网络权重数量几乎与目前世界上所有文本的单词数量一样多。但在某种程度上,我们仍然难以相信语言的全部丰富性及其所能表达的内容能够被封装在一个如此有限的系统中。这无疑部分反映了一种普遍存在的现象(该现象最初在 规则 30 的例子 中显现出来):计算过程实际上可以极大地放大系统的表观复杂性,即使其底层规则很简单。但实际上,正如我们前面讨论的,ChatGPT 中使用的这类神经网络往往经过专门构建,旨在限制这种现象及其相关的计算不可约性的影响,从而使其训练更加便捷。
那么,像 ChatGPT 这样的系统是如何在语言方面取得如此成就的呢?我认为,根本原因在于语言在本质上比表面看起来要简单得多。这意味着 ChatGPT——即使其神经网络结构最终显得如此简单——也能成功地“捕捉”人类语言及其背后思维的本质。此外,在训练过程中,ChatGPT 似乎“隐式地发现”了语言(和思维)中那些使这一切成为可能的规律。
我认为,ChatGPT 的成功为我们提供了一项基础且重要的科学发现的证据:它表明,我们可以期待发现一些全新的“语言法则”(实际上是“思维法则”)。ChatGPT 是一种神经网络,因此这些法则充其量是隐含的。但如果我们能够以某种方式将这些法则显式化,就有可能以更加直接、高效和透明的方式实现 ChatGPT 所做的一切。
好吧,那么这些定律究竟是什么样的呢?归根结底,它们必须为我们提供某种语言构成方式的指导——包括我们用语言表达的内容。稍后我们将讨论“深入了解 ChatGPT”如何能为我们提供一些线索,以及我们从构建计算语言中获得的知识如何指引我们前进的方向。但首先,让我们讨论两个早已为人所知的“语言定律”的例子,以及它们与 ChatGPT 运行方式的关联。
首先是语言的句法。语言并非随意堆砌的词语。相反,不同类型的词语如何组合在一起,有着(相当)明确的 语法规则 :例如,在英语中,名词前面可以接形容词,后面可以接动词,但通常两个名词不能紧挨着。这种语法结构(至少可以近似地)可以用一套规则来描述,这些规则定义了如何 构建类似“句法分析树”的结构 :

ChatGPT 本身并没有这些规则的明确“知识”。但它在训练过程中却能以某种方式隐式地“发现”它们,并且似乎很擅长遵循这些规则。这是如何实现的呢?从“宏观”层面来看,我们并不清楚。但为了更好地理解,或许我们可以看看一个更简单的例子。
考虑一种由括号(’s 和 )序列构成的“语言”,其 语法规定 括号必须始终保持平衡,其解析树如下所示:

我们能否训练一个神经网络来生成“语法正确”的括号序列?神经网络处理序列的方法有很多种,但我们不妨像 ChatGPT 那样使用 Transformer 网络。给定一个简单的 Transformer 网络,我们可以开始用语法正确的括号序列作为训练样本。一个微妙之处(实际上 ChatGPT 生成人类语言时也存在这个问题)是,除了“内容标记”(这里是“(”和“)”)之外,我们还需要包含一个“结束”标记,它用于指示输出不应再继续(也就是说,对于 ChatGPT 来说,这表示“故事结束了”)。
如果我们设置一个只包含一个注意力模块(8 个注意力头)且特征向量长度为128 的 Transformer 网络(ChatGPT 也使用长度为 128 的特征向量,但它有 96 个注意力模块,每个模块有 96 个注意力头),那么它似乎无法学习到太多关于括号语言的知识。但是,如果使用两个注意力模块,学习过程似乎就能收敛——至少在输入大约 1000 万个样本之后是这样(而且,正如 Transformer 网络常见的情况,输入更多样本似乎只会降低其性能)。
因此,借助这个网络,我们可以实现类似 ChatGPT 的功能,并请求下一个标记的概率——以括号序列的形式呈现:

在第一种情况下,网络“相当确定”序列不能在此处结束——这很好,因为如果序列结束,括号就会不平衡。然而,在第二种情况下,它“正确识别”了序列可以在此处结束,但同时也“指出”了“重新开始”的可能性,并添加了一个“(”,大概后面跟着一个“)”。但是,糟糕,即使它拥有大约 40 万个经过精心训练的权重,它仍然认为下一个标记是“)”的概率为 15%——这是不正确的,因为这必然会导致括号不平衡。
如果我们要求网络针对逐渐变长的 (‘) 序列给出概率最高的补全结果,我们会得到以下结果:

是的,在一定长度范围内,神经网络表现良好。但超过这个长度,它就开始失效。在神经网络(或者更广泛地说,在机器学习领域)处理这种“精确”场景时,这种情况相当常见。人类“一眼就能解决”的问题,神经网络也能解决。但对于需要进行“更算法化”操作(例如,显式地计算括号数量以判断其是否闭合)的问题,神经网络往往“计算能力不足”,无法可靠地完成。(顺便一提,即使是目前完整的 ChatGPT 也很难正确匹配长序列中的括号。)
那么,这对 ChatGPT 之类的工具以及英语这类语言的语法意味着什么呢?括号语言“严谨”,更像是一个“算法故事”。但在英语中,根据局部用词和其他线索来“猜测”语法上是否正确则更为现实。没错,神经网络在这方面做得更好——即使它可能漏掉一些“形式上正确”的例子,而这些例子人类也可能漏掉。但关键在于,语言整体的句法结构——以及由此蕴含的所有规律性——在某种意义上限制了神经网络需要学习的“量”。一个关键的“类似自然科学”的观察是,像 ChatGPT 这样的神经网络的 Transformer 架构似乎能够成功学习所有人类语言中(至少在某种程度上)存在的嵌套树状句法结构。
语法对语言是一种约束。但显然还有更多约束。像“好奇的电子吃蓝色理论当鱼”这样的句子语法正确,但并非人们通常会说的话,如果 ChatGPT 生成这样的句子,也不会被认为是成功的——因为,嗯,按照句子中词语的通常含义来看,它基本上毫无意义。
但是,是否存在一种通用的方法来判断一个句子是否有意义呢?目前还没有传统的、全面的理论来解释这个问题。不过,我们可以认为 ChatGPT 在经过数十亿条来自网络等地的(据推测有意义的)句子训练后,已经隐式地“发展出一套理论”。
这种理论会是什么样的呢?嗯,有一个领域两千年来一直为人所知,那就是 逻辑 。当然,在亚里士多德发现的三段论形式中,逻辑本质上是一种表达方式,它表明遵循某些模式的句子是合理的,而其他句子则不合理。例如,说“所有 X 都是 Y。这不是 Y,所以它不是 X”是合理的(就像“所有鱼都是蓝色的。这不是蓝色的,所以它不是鱼。”)。正如我们可以颇为奇特地想象亚里士多德通过“机器学习式”地浏览大量修辞学范例发现了三段论逻辑一样,我们也可以想象 ChatGPT 在训练过程中通过浏览网络上的大量文本等方式“发现了三段论逻辑”。(没错,因此我们可以预期 ChatGPT 能够生成包含基于三段论逻辑等“正确推理”的文本,但对于更复杂的形式逻辑,情况就截然不同了——我认为它在这方面会失败,原因与它在括号匹配中失败的原因类似。)
但抛开逻辑这个狭义的例子,我们还能如何系统地构建(或识别)哪怕是看似有意义的文本呢?诚然,像“疯狂填词” (Mad Libs) 这样的游戏会使用非常具体的“短语模板”。但 ChatGPT 似乎隐含着一种更为通用的方法。或许除了“当你拥有 1750 亿个神经网络权重时,它就自然而然地发生了”之外,我们无法解释它是如何实现的。但我强烈怀疑,背后存在着一个更简单、更有力的解释。
意义空间和语义运动定律
我们前面讨论过,在 ChatGPT 中,任何一段文本实际上都由一个数字数组表示,我们可以将其视为某种“语言特征空间”中某个点的坐标。因此,当 ChatGPT 继续输入一段文本时,就相当于在语言特征空间中追踪一条轨迹。但现在我们可以问,是什么使得这条轨迹对应于我们认为有意义的文本?是否存在某种“语义运动规律”来定义——或者至少约束——语言特征空间中的点如何在保持“意义性”的同时移动?
那么,这种语言特征空间是什么样的呢?下面举个例子,如果我们把这样的特征空间投影到二维平面上,单个词(这里指的是普通名词)可能会如何排列:

我们上面已经看到了另一个例子,它是基于表示植物和动物的词语。但这两个例子的关键在于,语义相似的词语被放在了一起。
再举一个例子,以下是不同词性对应的词语的排列方式:

当然,一个词通常并非只有“一个意思”(或者说,并非一定只对应一个词性)。通过观察包含某个词的句子在特征空间中的布局,我们通常可以“区分”出不同的含义——例如这里“crane”(鹤)这个词(是鸟还是机器?):

好的,所以至少我们可以把这个特征空间理解为将“意义相近的词语”放置在这个空间中彼此靠近。但是,我们还能在这个空间中识别出什么样的额外结构呢?例如,是否存在某种“平行传输”的概念来反映这个空间的“平坦性”?理解这一点的一个方法是考察类比:

是的,即使我们将其投影到 2D 上,通常也至少会有一点“平面感”,尽管这并非普遍可见。
那么轨迹呢?我们可以观察 ChatGPT 的提示在特征空间中遵循的轨迹——然后我们可以看到 ChatGPT 如何延续这一轨迹:

这里当然不存在“显而易见的几何运动定律”。这毫不奇怪;我们完全预料到 情况会复杂得多 。例如,即使存在某种“语义运动定律”,它也远非显而易见,因为最自然的表述方式(或者说,最有效的“变量”)是什么样的。
上图展示了“轨迹”中的几个步骤——每一步我们都选择 ChatGPT 认为最有可能出现的词(例如“零度温度”)。但我们也可以询问在给定点上,接下来可能出现的词的概率是多少:

我们在此例中看到的是,存在一个高概率词的“扇形”分布,它在特征空间中似乎朝着一个大致确定的方向延伸。如果我们继续深入观察会发生什么呢?以下是我们沿着轨迹“移动”时出现的连续“扇形”分布:

这是一个三维模型,总共需要 40 个步骤:

没错,这看起来一团糟——而且丝毫没有让人觉得,通过实证研究“ChatGPT 的内部运作”就能识别出“类似数学物理的”“语义运动规律”。但或许我们只是找错了“变量”(或者说坐标系),如果我们找对了变量,就能立刻发现 ChatGPT 正在做一些“数学物理上很简单”的事情,比如沿着测地线移动。但就目前而言,我们还没有准备好从 ChatGPT 的“内部行为”中“实证解码”出它“发现”的关于人类语言“构成方式”的秘密。
语义语法与计算语言的力量
究竟需要什么才能产生“有意义的人类语言”?过去,我们或许会认为这非人脑莫属。但现在我们知道,ChatGPT 的神经网络也能相当出色地完成这项任务。然而,这或许就是我们所能达到的极限,再也没有更简单——或者更易于人类理解——的语言能够奏效了。但我强烈怀疑,ChatGPT 的成功其实隐含地揭示了一个重要的“科学”事实:有意义的人类语言实际上比我们以往所知的要复杂得多,也简单得多——最终,或许存在一些相当简单的规则,可以描述这种语言是如何构建的。
正如我们前面提到的,句法语法规定了人类语言中不同词类等概念的词语如何组合在一起。但要处理语义问题,我们需要更进一步。一种方法是不仅要考虑语言的句法语法,还要考虑其语义语法。
就句法而言,我们会区分名词和动词之类的概念。但就语义而言,我们需要更细致的划分。例如,我们可以区分“移动”的概念,以及“物体”的概念,即“物体能够保持其自身特性,而与位置无关”。这些“语义概念”都有无数具体的例子。但就我们的语义语法而言,我们只需要一条通用规则,即“物体”可以“移动”。关于这一切如何运作,有很多可以讨论的地方( 其中一些我之前已经提到过 )。但在这里,我只简单谈谈一些可能的发展方向。
值得一提的是,即使一个句子在语义语法上完全正确,也不意味着它在实践中已经实现(甚至可能实现)。“大象去了月球”无疑符合我们的语义语法,但它在我们的现实世界中肯定还没有实现(至少目前还没有)——尽管在虚构世界中这完全没问题。
当我们开始讨论“语义语法”时,很快就会不禁要问:“它的底层是什么?”它假定了怎样的“世界模型”?句法语法实际上只是关于如何用词语构建语言。但语义语法必然与某种“世界模型”相关——这种模型就像一个“骨架”,语言正是建立在其上的,由实际的词语构成。
直到近代,我们或许还认为(人类)语言是描述我们“世界模型”的唯一通用方式。早在几个世纪前,人们就开始对特定类型的事物进行形式化描述,尤其基于数学。但现在出现了一种更为通用的形式化方法: 计算语言 。
是的,这正是我四十多年来的主要项目(如今已体现在 Wolfram 语言 中):开发一种精确的符号表示,它能够尽可能广泛地描述现实世界中的事物,以及我们关心的抽象概念。例如,我们拥有 城市 、 分子 、 图像 和 神经网络 的符号表示,并且内置了关于如何计算这些事物的知识。
经过几十年的努力,我们已经以这种方式涵盖了许多领域。但过去,我们并没有特别关注“ 日常话语 ”。在“我买了 2 磅苹果”这句话中,我们可以 很容易地表示 (并进行营养和其他计算)“2 磅苹果”。但我们(目前)还没有“我买了”这个概念的符号表示。
这一切都与语义语法的概念有关——其目标是为概念提供一个通用的符号“构建工具包”,从而为我们提供规则,告诉我们什么可以与什么组合在一起,从而为我们可能转化为人类语言的内容的“流动”提供规则。
但假设我们有了这种“符号话语语言”,我们该如何利用它呢?我们可以先从生成“局部有意义的文本”入手。但最终,我们可能更想要“全局有意义”的结果——这意味着要“计算”更多关于现实世界(或者某个连贯的虚构世界)中可能存在或发生的事情。
目前 Wolfram 语言内置了大量关于各种事物的计算知识。但要构建一个完整的符号话语语言,我们还需要构建关于世界一般事物的额外“演算”:如果一个物体从 A 移动到 B,又从 B 移动到 C,那么它就是从 A 移动到 C,等等。
| 给定一种符号话语语言,我们可以用它来发表“独立陈述”。但我们也可以用它来提出关于世界的问题,就像“Wolfram | Alpha”那样。或者,我们可以用它来陈述我们“想要表达”的事情,这大概需要某种外部驱动机制。或者,我们可以用它来做出断言——也许是关于现实世界,也许是关于我们正在思考的某个特定世界,无论它是虚构的还是真实的。 |
人类语言本质上是不精确的,这不仅是因为它不“绑定”于特定的计算机实现,其含义基本上是由使用者之间的“社会契约”定义的。但计算机语言本质上具有某种根本的精确性——因为它最终所指定的内容总能“在计算机上明确执行”。人类语言通常可以容忍一定的模糊性。(例如,当我们说“行星”时,它是否包含系外行星等等?)但在计算机语言中,我们必须精确、清晰地表达我们所做的所有区分。
在计算机语言中命名时,利用日常人类语言通常很方便。但这些名称在计算机语言中的含义必然是精确的——并且可能涵盖也可能不涵盖人类语言中某些特定的含义。
如何才能找到适合通用符号话语语言的基本“本体论”呢?这并不容易。或许正因如此,自两千多年前亚里士多德开创先河以来,我们在这方面进展甚微。但如今我们对如何用计算的方式思考世界有了如此多的了解,这确实大有裨益(而且,从我们的 物理项目 和 规则集(ruliad)的概念 中汲取的“基本形而上学”也功不可没)。
但这一切在 ChatGPT 的语境下意味着什么呢?ChatGPT 通过训练有效地“拼凑”出了一定数量的(相当可观的)语义语法。它的成功本身就让我们有理由相信,构建更完整的计算语言是可行的。而且,与我们目前对 ChatGPT 内部机制的了解不同,我们可以预期将计算语言设计得易于人类理解。
当我们谈论语义语法时,可以将其类比于三段论逻辑。最初,三段论逻辑本质上是一系列关于人类语言表达语句的规则。但是(是的,两千年后), 当形式逻辑发展起来后 ,三段论逻辑最初的基本结构就可以用来构建庞大的“形式塔”,例如,现代数字电路的运行就包含在其中。因此,我们可以预期,更通用的语义语法也将如此。起初,它可能只能处理简单的模式,例如以文本形式表达的模式。但是,一旦其完整的计算语言框架构建完成,我们就可以预期它将能够用来构建高耸的“广义语义逻辑”塔,使我们能够以精确和形式化的方式处理各种以前从未接触过的事物,而此前我们只能通过人类语言及其所有的模糊性,在“底层”进行初步的了解。
我们可以将计算语言(以及语义语法)的构建视为一种对事物表示方式的终极压缩。因为它使我们能够讨论事物本质的可能性,而无需处理例如日常人类语言中存在的所有“短语表达方式”。我们可以将 ChatGPT 的巨大优势视为与之类似:因为它在某种意义上也“深入挖掘”到了能够“以语义有意义的方式组合语言”而无需考虑各种不同短语表达方式的地步。
那么,如果我们把 ChatGPT 应用于底层计算语言会发生什么呢?计算语言可以描述可能性。但还可以添加的是对“流行趋势”的感知——例如,基于对网络上所有相关内容的阅读。此外,使用计算语言意味着像 ChatGPT 这样的系统可以直接且根本地访问那些用于进行潜在不可简化计算的终极工具。这使得它不仅能够“生成合理的文本”,还能推断出这些文本是否真正对世界——或者它应该描述的内容——做出了“正确”的陈述。
那么……ChatGPT 的作用是什么?它为什么有效?
ChatGPT 的基本概念在某种程度上相当简单。首先,它从网络、书籍等来源收集大量人类创作的文本样本。然后,训练一个神经网络来生成“类似这样的”文本。尤其重要的是,要让它能够根据“提示”开始,然后继续生成“类似于训练文本”的内容。
正如我们所见,ChatGPT 中的神经网络实际上由非常简单的元素构成——尽管数量高达数十亿。神经网络的基本运行方式也非常简单,本质上就是将它迄今为止生成的文本作为输入,并“依次遍历其所有元素一次”(没有任何循环等),对于它生成的每一个新词(或词的一部分)。
| 但令人惊讶的是,这个过程竟然能够生成与网络、书籍等现有内容“非常相似”的文本。它不仅语言通顺,而且能够根据提示“表达”内容,并利用其“阅读”过的内容。它表达的内容并非总是“通顺”(或符合正确的 计算结果)—— 因为(例如,在没有 [借助 Wolfram | Alpha 的“强大计算能力”的情况下](https://writings.stephenwolfram.com/2023/01/wolframalpha-as-the-way-to-bring-computational-knowledge-superpowers-to-chatgpt/) ),它只是根据训练材料中“听起来像”的内容,表达出“听起来正确”的内容。 |
ChatGPT 的独特工程设计使其极具吸引力。但归根结底(至少在它能够使用外部工具之前),ChatGPT “仅仅”是从它积累的“传统智慧统计数据”中提取出一些“连贯的文本线索”。然而,其结果与人类语言的相似度令人惊叹。正如我之前讨论过的,这揭示了一个至少在科学上非常重要的结论:人类语言(及其背后的思维模式)的结构比我们想象的更简单,也更符合“规律”。ChatGPT 已经隐式地发现了这一点。但我们或许可以通过语义语法、计算机语言等手段将其显式地揭示出来。
ChatGPT 在文本生成方面的表现令人印象深刻——而且生成的结果通常与我们人类的语言非常相似。那么,这是否意味着 ChatGPT 的工作原理与大脑类似呢?其底层的神经网络结构最终是基于大脑的理想化模型构建的。而且,我们人类在生成语言时,许多方面似乎也与之非常相似。
在训练(即学习)方面,大脑和现有计算机不同的“硬件”(以及一些可能尚未成熟的算法理念)迫使 ChatGPT 采用一种与大脑截然不同(在某些方面效率也低得多)的策略。此外,还有一点:与典型的算法计算不同,ChatGPT 内部没有“循环”或“数据重复计算”。这必然限制了它的计算能力——即使与现有计算机相比也是如此,更不用说与大脑相比了。
目前尚不清楚如何“解决这个问题”,同时还能保持系统训练的合理效率。但这样做应该能让未来的 ChatGPT 完成更多“类似大脑的事情”。当然,大脑也有很多不擅长的事情 —— 尤其是一些不可简化的计算。对于这些事情,无论是大脑还是像 ChatGPT 这样的系统,都需要借助“外部工具”——比如 Wolfram 语言 。
但就目前而言,看到 ChatGPT 已经取得的成就令人兴奋。在某种程度上,它很好地诠释了一个基本的科学事实:大量的简单计算单元可以完成非凡且出乎意料的事情。同时,它也为我们提供了两千年来最有力的推动力,让我们能够更好地理解人类语言这一人类生存核心特征及其背后的思维过程的根本性质和原理。